 お問い合わせ
数量化理論の解説
質的データとは、性別や血液型、職業などのように分類や種類を区別するためのデータです。数量化理論は、その質的データを量的データ(年齢や金額などの数値化できるデータ)のような測度に変換する手法を指します。
なお、数量化理論は、I〜VI類までの6つの手法群に分かれています。数量化理論の中でも、よく知られている手法群は以下のI〜IV類です。
数量化理論の手法群 | 特徴 | 分析法のねらい |
数量化I類 | 質的データを用いた重回帰分析 | 結果変数の予測 |
数量化II類 | 質的データを用いた判別分析 | 未知データの分類 |
数量化III類 | 質的データを用いた主成分分析 | 多くの変数の情報を要約 |
数量化IV類 | 質的データを用いた多次元尺度構成法 | データのグループ分け |
数量化I類とは
数量化I類は質的データを用いた重回帰分析です。
重回帰分析とは、複数の量的な説明変数から1つの目的変数を予測する方法で、「y=a1x1 +a2x2+a2x2+a3x3+…+b」のような式で表されます。
通常は「y」が目的変数で「x」が量的変数ですが、「x」の部分を質的変数にすると、数量化I類の手法となります。
数量化I類を用いてわかることは、以下のとおりです。
説明変数の目的変数(各カテゴリ)に対する貢献・影響度
広告注目率や店舗の売上などの予測 など
たとえば、あるお好み焼き屋で「豚玉味」と「キムチ味」「海鮮味」の売上が日によってバラついていたとします。
天候と気温、日付、曜日(説明変数)から3種類のお好み焼きの売上(目的変数)を予測する際、それぞれの味にどの説明変数が重要なのかを把握できると、適切な仕入れ量を割り出すことが可能です。
数量化I類で分析を行うと、食品を余計に仕入れすぎたり機会損失を防いだりできます。
数量化II類とは
数量化II類とは、質的データを用いた判別分析です。
判別分析とは、グループ分けされたデータを元に、どのような人がそのグループに属するのかを分析する手法を指します。その結果を元に、分類されていないデータ・サンプルがどちらのグループに属するのかを予測します。
数量化II類を用いると、以下のようなことがわかります。
説明変数カテゴリと目的変数カテゴリとの関連性
購買につながるターゲット層や顧客におすすめの商品などの判別(予測) など
たとえば「転職したい」を目的変数として、社会人に以下のような質問を行ったとします。
Q1:あなたはそれぞれについてどの程度当てはまりますか。 | 選択肢 |
| 1 / 2 / 3 / 4 / 5 |
キャリアアップしたい | 1 / 2 / 3 / 4 / 5 |
やりがいが少ない | 1 / 2 / 3 / 4 / 5 |
人間関係に不満がある | 1 / 2 / 3 / 4 / 5 |
これらの結果を数量化II類で分析すると、それぞれの質問項目が「転職したい」という目的変数にどのような影響を与えているかを調べることが可能です。
数量化III類とは
数量化III類は、質的データを用いた主成分分析です。
以下のような質問と選択肢があったとします。
質問 | 選択肢 |
Q1:あなたはどのお酒をよく飲みますか?当てはまるものすべてをお選びください。 | ビール / ワイン / カクテル / サワー / 日本酒 / ウイスキー / 焼酎 |
Q2:あなたの年齢層を教えてください。 | 20代 / 30代 / 40代 / 50代 / 60代 |
集計した結果、20代は「カクテル」、30代は「ビール」、40代は「サワー」50代は「焼酎」、60代は「日本酒」と回答した人の割合が多いことがわかったとします。
このデータを元に主成分分析を行うと、「20代は甘いお酒を好む傾向がある」や「年を重ねるごとにアルコール度数の強いお酒を好むようになる傾向にある」のように、大まかな傾向の把握が可能です。
数量化III類では、似たような回答パターンをする人に似たスコアを与え、数量化します。
数量化IV類とは
数量化IV類は、質的データを用いた多次元尺度構成法です。多次元尺度構成法は、類似データを視覚的にわかりやすい形に変換する分析手法を指します。
分析結果は、以下のような「ポジショニングマップ」で表されます。
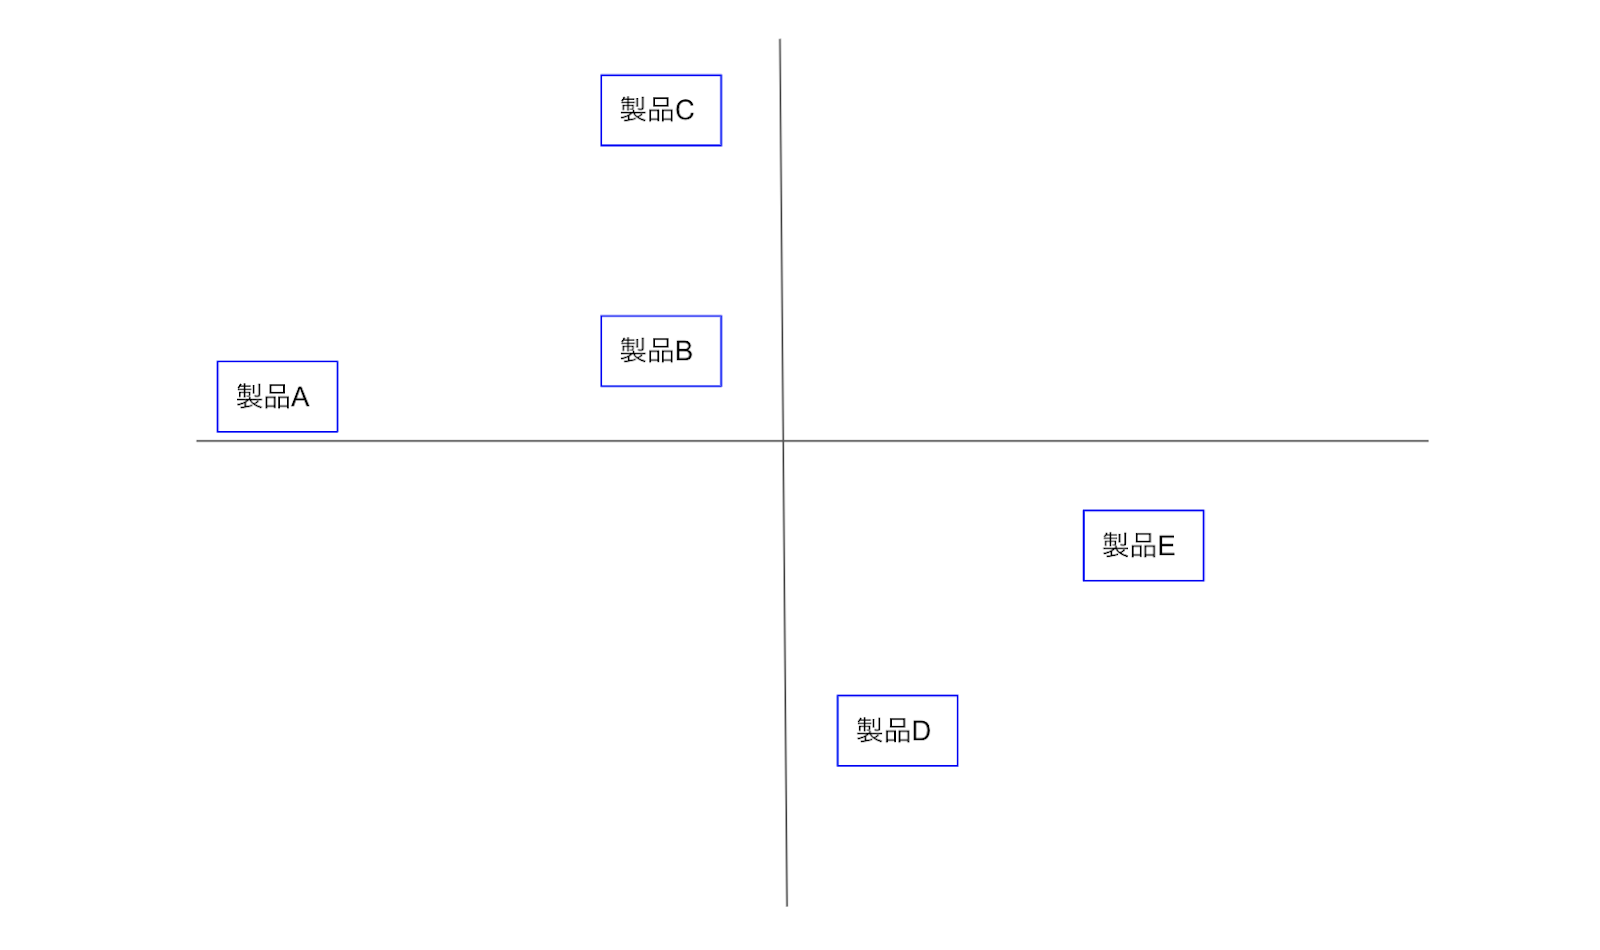
以下のように、複雑なデータ間の関係性をわかりやすくグラフ化したい場合におすすめの方法です。
競合他社の製品のポジションや関係性をポジショニングマップで把握し、それを元に自社製品の開発方針を検討する
売れる商品と売れない商品の差を把握・検討する など
数量化理論のまとめ
数量化理論とは、いくつかの調査項目を無理矢理にひとつの変数と捉えるのではなく、カテゴリに分解して、それぞれに適切なウエイトを与える方法です。
I〜VI類までの6つの手法群に分かれており、それぞれが各手法と対応関係にある理論です。質的データを数量化することで、分析をし易くするために用いられます。
特によく用いられるのは数量化理論I〜IV類で、それぞれ「結果変数の予測」「未知データの分類」「多くの変数の情報を要約」「データのグループ分け」といった狙いで利用される理論です。