 お問い合わせ
この記事でわかること
自由記述(定性データ)と選択式設問(定量データ)の性質の違いと、それぞれを設置・分析する目的
読み込み・要約、コーディング、頻出語分析など、自由記述回答を読み解く代表的な分析手法
回答件数(処理の重さ)と分析目的(アウトプット)に応じた、最適なアプローチの選び方
家計簿アプリの実例に見る、生成AIを活用した分類コード案の作成・修正・集計の実践的な手順
自由記述の分類結果を満足度や利用意向などの定量データと掛け合わせ、真の課題を浮き彫りにするコツ
分類基準のブレ、AIの誤分類、件数だけで重要度を判断するリスクなど、陥りやすい失敗と対策
せっかく集めた自由記述が有効に活かされない背景には、表記ゆれによる読みづらさや、担当者の主観による構造化の不足が存在します。
顧客の声を単なる感想で終わらせず、確かな施策の根拠に変えるためのアフターコーディングの手順を整理しました。実務で陥りがちな分類基準のばらつきを防ぐ具体的な対策も合わせて提示します。
1. 導入:自由記述は「読むだけ」では活用しにくい
アンケートの自由記述回答は、選択肢ではすくい取れない回答者の本音や、設計段階で想定していなかった情報を引き出せる設問形式です。
満足度が低い理由や商品を選ばなかった背景、改善の要望など、数値化できない具体的なエピソードが生の言葉として残る点に大きな価値があります。
しかし、せっかく集めた回答が有効に活かされないケースも少なくありません。テキスト情報の羅列として示される定性情報は、集計結果として定量化される選択式の設問に比べて分析しにくいことがその理由です。
自由回答を活かせない背景には、主に3つの要因が存在します。
読みづらさ:表記ゆれや短すぎる回答などのノイズが混ざることで、全体像を把握する前に分析が滞ってしまう。
定量データとの分断:自由回答のみを独立して読み進めるため、どの属性のユーザーがどのような不満を抱いているのかまで特定できない。
構造化の不足:収集した意見を整理せず、出現件数や課題の深刻度を考慮しないまま、担当者の印象で対応の優先順位を決めてしまう。
これら3つの要因以前に、そもそも有効な自由記述回答が十分に集まらないという点も、アンケート調査業務のなかではよく指摘されることです。
より多くの回答を集めるための自由記述の設問の作り方については、以下の記事をご覧ください。
本記事では、自由記述を感想の羅列で終わらせず、意思決定に使える情報として扱うための基本的な考え方と進め方を解説します。
2. 基礎知識:自由記述分析で押さえる考え方
自由記述回答を分析する目的と、テキスト情報として集められる自由記述の定性データと選択肢の合計として出力される定量データのそれぞれの役割を整理します。
この前提を押さえておくと、自由記述回答を定量結果と関連付けて読む狙いが明確になります。
2-1. 自由記述とは
アンケート調査の回答形式における自由記述は、あらかじめ用意された選択肢から選ぶのではなく、回答者が自分の言葉で入力・記入する方法で回答するもののことです。
数値で答える場合も自由記述に含まれますが、本記事では、文章や単語で回答されるものを主な対象として扱います。
2-2. 自由記述回答を設置・分析する目的
自由記述を設定し、それを分析することには以下のような目的があります。
理由や背景を解釈する
選択式設問の後に具体的な理由や背景を重ねて尋ねることで、その選択肢を選んだ理由や動機を詳しく紐解くことが目的です。 その回答を選んだ評価プロセスや文脈を把握するために用います。想定外の情報を発見する
選択肢の「その他」欄や自由記入欄を設けることで、設計段階では予測できなかった新たな視点や課題を見つけ出すことができます。 あらかじめ用意した枠組みにとらわれない意見を拾い上げ、次の施策へのヒントや改善につなげます。回答者のナマの言葉を捉える
回答者が日常的に使っている言葉遣いや、表現のニュアンスをそのまま把握します。回答者のリアルな語彙に触れることで顧客への理解を深め、メッセージの最適化などに活かします。回答者に心理的報酬を与える
調査テーマへの関心が高い回答者に対し、自身の意見や想いを主体的に発信する場を提供する目的です。 伝えたい欲求を満たすことで、調査への参加に対する納得感や好意的な印象を高める効果があります。
2-3. 自由記述(定性データ)と定量データの分析方法の違い
自由記述(定性データ)と定量データは、扱う情報の性質と使い道が異なります。
項目 | 自由記述(定性データ) | 定量データ |
回答形式 | 文章、単語、具体的な意見 | 選択肢、数値、尺度評価 |
分かること | 理由、背景、具体的な状況、想定外の論点 | 全体傾向、割合、差の大きさ |
単独では分かりにくいこと | 全体に占める割合や件数の大小 | 数値の背景にある理由や文脈 |
主な使い道 | 数値の背景の解釈、代表的な意見の提示、新たな論点の発見 | 現状把握、層ごとの比較、差がある箇所の特定 |
上の表のようなデータの性質の違いにより、自由記述の分析方法は以下のような特徴を持っています。
目的と問いの性質(探索)
「なぜ?」「どのように?」といった探索的な問いに対する答えを得ることが目的です。事前に想定していなかった新たな視点や、数値の裏にある理由やプロセスを明らかにします。データの構造と扱い方(非構造化)
自由記述は、そのままでは集計や処理が難しい非構造化データです。意味のある単位に文章を区切り、内容に応じたラベルを付与するといった作業を経て、初めて整理されたカテゴリとして扱えるようになります。分析のプロセス(主観の介入)
テキストを読み解く工程では、どうしても分析者の主観の介入が起こります。誰がやっても同じ結果になるわけではありませんが、そのぶん言葉の文脈やニュアンスを汲み取った深い考察が可能になります。得られる知見の深さ(ナラティブ)
回答者の生の声や、個別のエピソードといったナラティブ(物語)を獲得できる点が大きな強みです。数値だけでは見落とされがちな、想定外のニーズや細かな不満の背景を深く捉えられます。必要なリソースとスキル
全件の読み込みや分類、解釈などの工程を経るため、相応の時間と労力がかかります。集まったバラバラの言葉を客観的に抽象化し、整理していく構造化の思考力が求められます。信頼性と妥当性の確保
解釈の偏りを防ぐため、複数人で分類基準をすり合わせたり、内容を再確認したりする工夫を行います。こうしたプロセスを踏むことで、分析結果における信頼性と妥当性を担保します。
2-4. 自由記述回答の主な分析手法
自由記述回答の分析手法は、回答を読み込んで意味を解釈する方法、回答内容を分類して件数化する方法、テキストマイニングによって語句の傾向を把握するなど、さまざまな方法があります。
分析手法 | 概要 | 主な使い道 |
読み込み・要約 | 回答を読み、主な意見や印象的なコメントを整理する方法 | 少数回答の傾向把握、代表的なコメントの確認 |
コーディング | 回答内容にあらかじめ分類ラベルを付けて、テーマ別に整理する方法 | 評価の理由、要望などの分類 |
アフターコーディング | 回答内容に応じた適切な分類を見極めながら、件数や割合として集計する方法 | 自由記述の定量化、選択式設問との比較 |
頻出語分析 | 回答内に多く出てくる単語を抽出する方法 | 大量回答の傾向把握、論点の洗い出し |
共起分析 | 複数の語句がどのように一緒に使われているかを見る方法 | 回答者がどの言葉を結び付けて語っているかの確認 |
感情分析 | 回答を肯定的・否定的・中立的な内容に分類する方法 | 評価の方向性や不満の多さの確認 |
代表コメント抽出 | 各カテゴリや傾向を象徴する回答を抜き出す方法 | 報告書・提案資料での具体例提示 |
AI・自動分類 | 生成AIや分析ツールを使って回答の要約や分類を補助する方法 | 大量回答の一次整理、分類案の作成 |
回答件数が少ない場合と多い場合では、適した分析方法が異なります。また、組み合わせて使うことで、自由記述の価値を引き出しやすくなります。
3. 実践ステップ:回答件数と分析目的で手法を使い分ける
前述のとおり、自由記述の分析にはいくつかのやり方があり、自由記述回答の件数と何を目的に分析するかを目安として使う手法を選択します。
件数と目的の2つの軸で手法を選び、定量データと掛け合わせて施策につなげるまでの流れを示します。厳密な手順というより、状況に応じた選び方として捉えてください。
3-1. STEP 1 手法は回答件数と分析目的で選ぶ
自由記述をスムーズに、かつ深く分析するためには、次の2つの視点からアプローチを選択します。
回答件数(処理の重さを決める軸)
対象と自由記述回答の件数が人の目で読み通せる規模なのか、あるいは機械的な処理に切り替えるべき規模なのかによって進め方が変わります。件数が増えるほど人手による負担は重くなるため、機械的な処理の比重を高めていく必要があります。分析目的(取り出したい出力を決める軸)
全体の傾向をつかみたいのか、意見を分類して数値化したいのか、あるいは個々の背景を深く理解したいのかによって、適した手法は異なります。
3-2. STEP 2 回答件数で処理の進め方を決める
回答件数は、全件を読めるか、分類や自動処理に頼るかの分かれ目になります。おおよその目安は次の通りです。
回答件数 | 主に使う手法 | 選ぶ理由 |
~50件 | 読み込み・要約、手動でのコーディング、代表コメント抽出 | 全件を読めるため、目視が最も速く正確。AIやテキストマイニングでは手戻りが発生した場合に手間がかかる |
~500件 | アフターコーディング、内容分析、AIによる自動分類(分類の下案づくり) | 全件を読むのが重くなり、分類して件数化する段階に入る。AIは素案づくりに役立つが、誤分類の確認が必要 |
500件~ | 頻出語分析・共起分析、AIによる要約・自動分類 | 全件を目視することは非現実的。頻出語分析などで全体を俯瞰する。 |
回答の長さや内容のばらつきによって前後しますが、数百件でも単語や短い文章で論点が限られていれば、スプレッドシート等を使って手作業で行うほうが、結果を見ながら分類やコーディングを進める際の自由度が高くなります。
一方、数十件でも一件あたりのテキストの情報量が多ければ読み込みに時間がかかるため、AIや専用ソフト等を使うほうが効率的です。
生成AIを使う場合は、人の目で誤分類を確認する作業が不可欠ですが、AIの性能向上が目覚ましく、カテゴライズやラベリングの精度は高くなっています。
生成AIを使った具体的な分析手順と、分類・検証の事例は以下の記事で解説しています。
3-3. STEP 3 分析目的で手法を使い分ける
何を知りたいかによって、使う手法は変わります。主な目的と手法の対応は次の通りです。
分析目的 | 主に使う手法 | 得られるもの |
傾向をつかむ | 頻出語分析、感情分析 | よく出る論点、評価の方向性 |
分類・定量化する | コーディング、アフターコーディング | カテゴリ別の件数や割合 |
背景や具体例を理解する | 読み込み・要約、内容分析、代表コメント抽出 | 数値の背景にある理由や文脈、提示できる具体例 |
定量データと関連づける | 属性別分析 | どの層にどの意見が多いか |
自由記述の分析を進める際は、最初から特定の手法ひとつに絞るのではなく、知りたい内容に合わせて複数のアプローチを組み合わせます。
検証したい目的が複数ある場合は、全体傾向の把握 → 分類・定量化 → 背景の理解 → 属性別の確認という順序を意識すると、集まった生の声をスムーズに施策の判断材料へと結び付けやすくなります。
例えば、まずは頻出語分析などで回答全体に多く出てくる論点を捉えて全体傾向の把握を行い、その後にコーディングを用いて意見をグループ分けすれば、主観に偏らず客観的な件数や割合として分類・定量化が可能です。
さらに、特徴的なカテゴリに絞って実際の回答文を読み込み、代表的なコメントを抽出して背景の理解を深めることで、数値だけでは伝わりにくい具体的な状況を説明しやすくなります。
反対に、ゴールが曖昧なまま手探りで分析を始めてしまうと、頻出語の一覧を出して終わったり、たまたま目についた一部の意見だけに引きずられてしまいがちです。
どのような判断をしたいのかをあらかじめ明確にし、その判断に必要なアウトプットから逆算して適した方法を選ぶようにします。
3-4. STEP 4 定量データと掛け合わせて施策につなげる
自由記述分析の結果を施策に活かすには、コメントの内容を整理するだけでなく、選択式設問や回答者属性などの定量データと組み合わせて見る必要があります。
自由記述と定量データを掛け合わせる際は、主に次のような観点で整理します。
掛け合わせるデータ | 確認する内容 |
評価データ(満足度・NPS・購入意向など) | 評価の高低と自由記述の内容にどのような関係があるか |
属性データ(年齢・性別・職業など) | 特定の意見がどの回答者層に多いか |
行動データ(利用頻度・利用期間・購入回数など) | 意見や不満がどの利用段階で生じているか |
自由記述で多く見られた意見であっても、全体に広く分布しているのか、特定の層に集中しているのかによって、施策の方向性は変わります。
また、件数としては少ない意見でも、低評価や離脱意向と強く結び付いている場合は、優先的に検討すべき課題になることがあります。
施策化の段階では、自由記述の件数だけで判断するのではなく、次のような視点を組み合わせて優先順位を決めます。
判断軸 | 確認する内容 |
発生規模 | どの程度の回答者が同じ論点に言及しているか |
影響度 | 満足度低下、購入中止、解約意向などに関係しているか |
対象層 | 重要顧客や注力したい層に多く見られる意見か |
改善可能性 | 短期で対応できる内容か、中長期で取り組む内容か |
分析結果をレポートにまとめる際は、カテゴリ別の件数や割合で全体像を示しつつ、必要に応じて代表的なコメントを添えると、数値と背景の文脈をバランスよく伝えられます。
具体的な文脈を補うことで、関係者が課題の内容を深く理解しやすくなる効果もあります。
最終的には、自由記述の分析結果から「どの課題に対応するか」「どの層に向けて改善するか」「どの施策から着手するか」という具体的な判断へと結び付けていきます。
4. 事例・サンプル
自由記述回答のアフターコーディングのやり方を、実際のアンケートの例を使って解説します。
4-1. サンプルデータの前提
家計簿・支出管理アプリの満足度調査の事例を取り上げます。
調査は、過去3か月以内に家計簿・支出管理アプリを利用した20〜50代男女を対象に、アプリの満足度・利用実態・改善要望を聴取したものです。
回収数は920件、そのうち自由記述欄に入力があった回答は86件、ここから「特になし」「ありません」など、具体的な改善要望が読み取れない回答や、設問の趣旨から外れる回答は除外した79件を自由記述回答の分析対象としています。
自由記述設問では、次のように改善要望を尋ねています。
【具体例】家計簿・支出管理アプリの利用実態と改善要望調査
設問 | Q6:このアプリをさらに使いやすくするために、 改善してほしい点があれば自由にお書きください。 |
アフターコーディングでは、自由記述を読んで似た内容を分類し、あとからカテゴリ別に件数や割合を集計できる状態に整えます。
以降では、この79件の自由記述回答を対象に、ローデータの確認、生成AIによる分類コード案の作成、人による修正、件数・割合の集計という順に進めていきます。
4-2. ローデータを確認し、分析対象を整える
まずは、自由記述回答のローデータを確認します。この段階では、まだ分類コードを付けたり、件数を集計したりする必要はありません。
目的は、回答者がどのような観点で改善要望を書いているのかを把握し、分析に使える回答を整理することです。
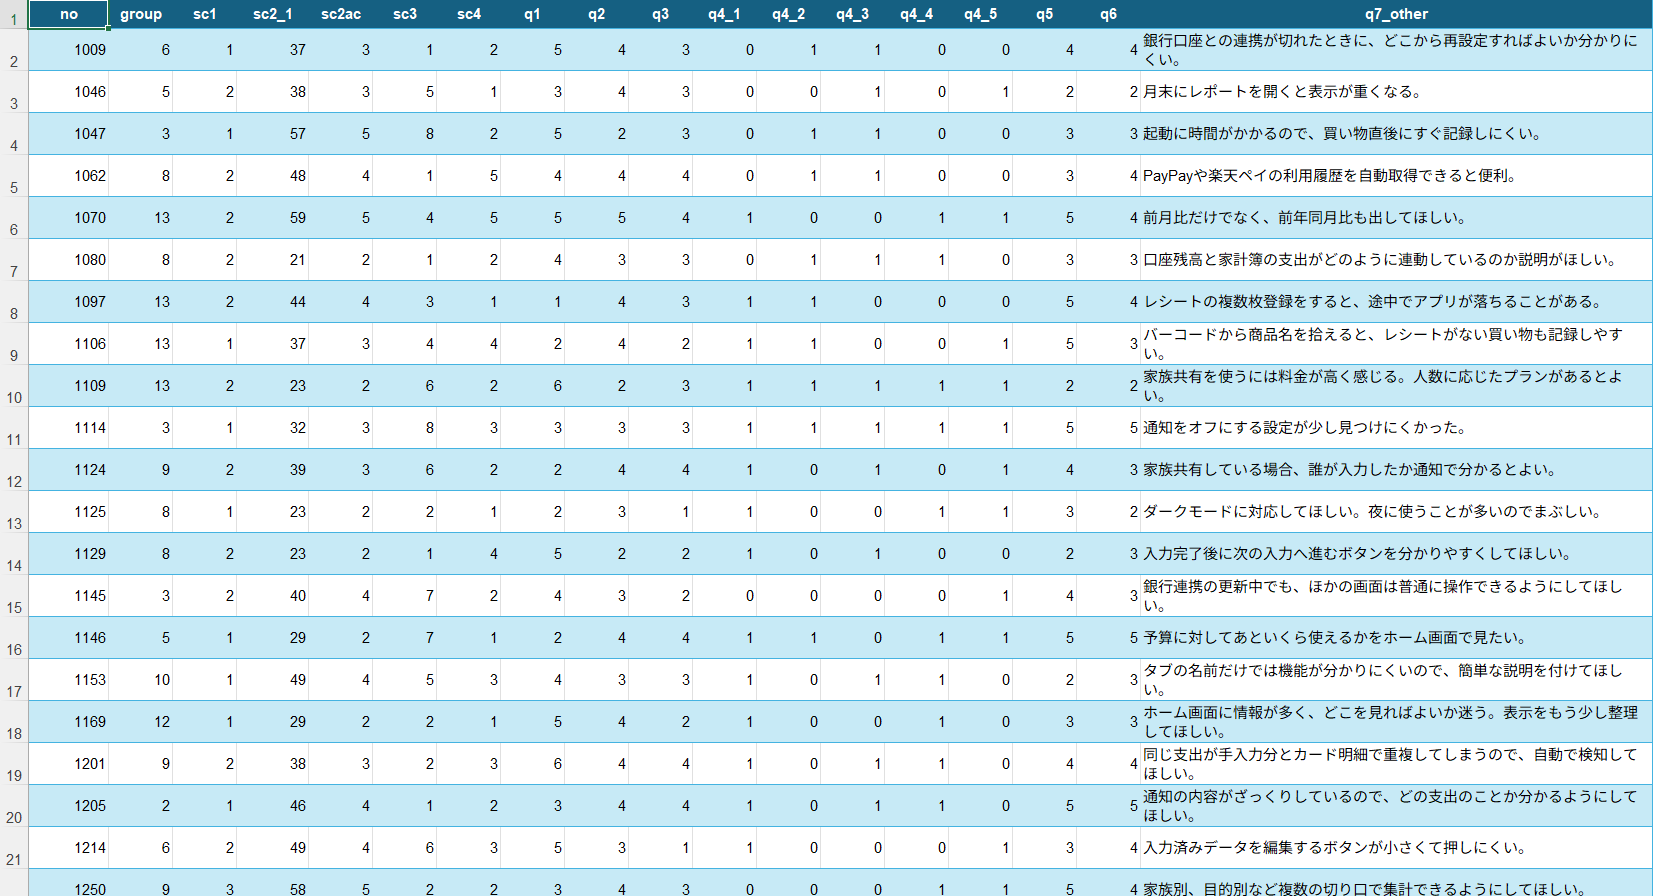
自由記述回答は、選択式設問のようにあらかじめ項目がそろっているわけではありません。同じ改善要望でも、回答者によって表現の仕方は異なります。また、1つの回答の中に複数の論点が含まれる場合もあります。
今回のサンプルデータには、次のような回答が含まれています。
回答例 | 読み取れる論点 |
銀行口座との連携が切れたときに、どこから再設定すればよいか分かりにくい。 | 連携、再設定導線、説明不足 |
月末にレポートを開くと表示が重くなる。 | レポート、表示速度 |
レシート撮影後の読み取り精度を上げてほしい。店名や合計金額がよくずれる。 | レシート読み取り、精度 |
家族共有を使うには料金が高く感じる。人数に応じたプランがあるとよい。 | 家族共有、料金プラン |
ホーム画面に情報が多く、どこを見ればよいか迷う。 | 画面設計、情報量、導線 |
ローデータを見ると、回答者は画面の分かりにくさ、動作の重さ、銀行口座やカードとの連携、レシート読み取り、料金プランなど、さまざまな観点から改善要望を書いていることが分かります。
このままでは、どの要望が多いのか、似た意見をどこまで同じものとして扱うのか、どの課題から優先して検討するのかを判断しにくい状態です。
具体的には「画面が分かりにくい」という回答と「再設定の場所が分からない」という回答は、どちらも操作導線に関する不満としてまとめられる可能性があります。
一方で、「レポート画面が重い」という回答は、画面設計ではなく動作速度の問題として分けたほうが、改善策を考えやすくなります。
そのため、ローデータを確認する段階では、まず回答ごとに読み取れる論点を簡単にメモしておきます。このメモは最終的な分類コードではなく、あとで分類案を作るための下準備です。
4-3. 生成AIで分類コードの下案を作成する
ローデータを確認したら、次に自由記述回答を分類するためのコード案を作成します。
今回の分析対象は79件です。この規模の件数であれば全件を人の目で読むことは可能ですが、似た意見をまとめたり、カテゴリの粒度をそろえたりしながら、人力で分類コードをゼロから作るのは時間を要します。
生成AIに自由記述回答を読み込ませることで、この労力を大幅に削減できます。生成AIにローデータをアップロードして、次のようなプロンプトを渡します。
【プロンプト】
以下は、家計簿・支出管理アプリの改善要望に関する自由記述回答です。 回答内容を読み、アフターコーディングに使う分類コード案を作成してください。
条件:
・回答文に書かれている内容だけをもとに分類する
・似た意味の回答は同じカテゴリにまとめる ・カテゴリが細かくなりすぎないようにする
・カテゴリ名、カテゴリの定義、該当する回答例を表で出す
・判断が難しいものは「要確認」とする
次のような結果が出力されます。
分類コード案 | 定義 | 該当する回答例 |
画面・導線・設定の分かりやすさ | 画面構成、ボタン配置、設定場所、操作導線に関する改善要望 | ホーム画面に情報が多く、どこを見ればよいか迷う。 |
動作速度・安定性 | 起動、読み込み、同期、フリーズ、アプリ落ちに関する改善要望 | 月末にレポートを開くと表示が重くなる。 |
銀行・カード・決済連携 | 銀行口座、クレジットカード、QR決済、電子マネーとの連携に関する改善要望 | 銀行口座との連携が切れたときに、どこから再設定すればよいか分かりにくい。 |
レシート読み取り・保存 | レシート撮影、読み取り精度、画像保存に関する改善要望 | レシート撮影後の読み取り精度を上げてほしい。 |
料金・プラン・広告 | 有料プラン、無料プラン、広告、家族向け料金に関する不満や要望 | 家族共有を使うには料金が高く感じる。 |
生成AIが出力した結果に対して、カテゴリの粒度が調査目的に合っているか、施策検討に使いやすい分類になっているかまでは、人が確認する必要があります。
次のステップでは、生成AIが出した分類案を人の目で確認し、重複や粒度のばらつきを整えていきます。
4-4. 仮コード付きのローデータを確認し、分類を修正する
分類コード案を作成したら、次に各回答へ仮コードを付与します。ここでは、ローデータに生成AIが判断した仮コードを加え、確認用の表を作成します。
生成AIには次のように指示します。
【プロンプト】
以下の自由記述回答に、先ほど作成した分類コード案をもとに仮コードを付与してください。
出力項目:
回答ID
自由記述回答
仮コード
判断理由
・要確認フラグ
要確認フラグ
条件:
1回答につき主な論点を1つ選び、仮コードを付ける
複数の論点がある場合は、最も中心的な論点を仮コードにする
判断が難しい回答は、要確認フラグを「要確認」とする
回答文に書かれていない内容は推測しない
表形式で出力する
この指示により、自由記述本文と仮コードを同じ表で確認できるようになります。生成AIが出力した表は、次のような形を想定します。
回答ID | 自由記述回答 | AIの仮コード | 判断理由 | 要確認フラグ |
012 | 銀行口座との連携が切れたときに、どこから再設定すればよいか分かりにくい。 | 銀行・カード・決済連携 | 銀行口座連携に関する不満が中心 | |
027 | 月末にレポートを開くと表示が重くなる。 | レポート・集計・グラフ | レポート画面に関する不満 | 要確認 |
041 | 家族共有を使うには料金が高く感じる。人数に応じたプランがあるとよい。 | 家族共有・権限 | 家族共有に関する要望が含まれる | 要確認 |
058 | ホーム画面に情報が多く、どこを見ればよいか迷う。 | 画面・導線・設定の分かりやすさ | 画面構成と導線に関する不満 |
この表をもとに、回答本文と仮コードを照合します。確認するのは、AIの分類が回答内容に合っているか、カテゴリの粒度がそろっているか、複数論点を含む回答の扱いが妥当かという点です。
たとえば、回答ID027の「月末にレポートを開くと表示が重くなる。」は、レポート内容への要望ではなく、表示速度に関する不満です。この場合、仮コードを「レポート・集計・グラフ」から「動作速度・安定性」に修正します。
回答ID041の「家族共有を使うには料金が高く感じる。人数に応じたプランがあるとよい。」は、「家族共有・権限」と「料金・プラン・広告」の両方に関係します。
今回の集計では、主な論点を1つに絞るため、料金への不満を中心に見るなら「料金・プラン・広告」に修正します。家族共有に関する論点は、メモ欄や副コードに残します。
人手で確認した後の表は、次のように修正します。
回答ID | 自由記述回答 | AIの仮コード | 修正後コード |
012 | 銀行口座との連携が切れたときに、どこから再設定すればよいか分かりにくい。 | 銀行・カード・決済連携 | 銀行・カード・決済連携 |
027 | 月末にレポートを開くと表示が重くなる。 | レポート・集計・グラフ | 動作速度・安定性 |
041 | 家族共有を使うには料金が高く感じる。人数に応じたプランがあるとよい。 | 家族共有・権限 | 料金・プラン・広告 |
058 | ホーム画面に情報が多く、どこを見ればよいか迷う。 | 画面・導線・設定の分かりやすさ | 画面・導線・設定の分かりやすさ |
この修正作業を行うことで、生成AIの出力をそのまま使う場合に起こりやすい誤分類を減らせます。
確認の際は、次の観点を見ます。
確認観点 | 見直す内容 |
分類の妥当性 | 自由記述本文と仮コードが合っているか |
粒度 | カテゴリが細かすぎないか、広すぎないか |
重複 | 似たカテゴリが分かれていないか |
漏れ | どのカテゴリにも入らない回答が多くないか |
複数論点 | 主コードと副コードの扱いが明確か |
集計しやすさ | 件数や割合として集計できる形になっているか |
修正後のローデータは、次の集計工程で使用します。生成AIに再度読み込ませる場合も、AIの仮コードではなく、人が確認した「修正後コード」を集計対象にします。
4-5. 修正後コードをもとに件数と割合を集計する
分類コードの確認・修正が終わったら、修正済みのローデータを集計します。
従来は、アフターコーディングしたローデータを再びアンケート集計ソフトに読み込ませ、カテゴリー化した自由記述設問を新たな設問に加える設定を行った上で、集計・分析作業を行うという流れでしたが、この作業も生成AIを使って行うことができます。
この事例のように、ローデータをCSVやエクセルファイルを添付する形で生成AIに渡すと、生成AI側で自動的にコード実行環境が立ち上がり、生成AI特有の計算ミス(ハルシネーション)が起こることなく、正確にアンケート集計を実行できます。
ただし、無料プランや一部の生成AIモデルでは、ファイル添付が出来てもコード実行(データ分析)が使えない、または、回数制限が厳しいことがあるので注意が必要です。
また、無回答や欠損値の処理などのルールをプロンプトで正しく指示する必要があります。
生成AIを使って集計する場合は、修正済みローデータを読み込ませ、次のように指示します。
【プロンプト】
以下は、自由記述回答のローデータです。「修正後コード」を基準に、分類コード別の件数と構成比を集計してください。
条件:
AIの仮コードではなく、「修正後コード」を使う
分析対象件数は79件とする
構成比は「件数 ÷ 79」で計算する
構成比は小数点1桁で表示する
分類コード別に件数の多い順で並べる
表形式で出力する
以下の集計結果が出力されます。
分類コード | 件数 | 構成比 |
画面・導線・設定の分かりやすさ | 15件 | 19.0% |
銀行・カード・決済連携 | 11件 | 13.9% |
レシート読み取り・保存 | 9件 | 11.4% |
動作速度・安定性 | 8件 | 10.1% |
料金・プラン・広告 | 8件 | 10.1% |
レポート・集計・グラフ | 7件 | 8.9% |
入力・記録補助 | 6件 | 7.6% |
家族共有・権限 | 5件 | 6.3% |
ヘルプ・説明・初期設定 | 4件 | 5.1% |
データ出力・外部連携 | 3件 | 3.8% |
通知・リマインド | 2件 | 2.5% |
セキュリティ・プライバシー | 1件 | 1.3% |
合計 | 79件 | 100.0% |
このように件数と構成比を出すことで、自由記述回答をカテゴリ別の定量データに変換することができます。
自由記述の件数は、あくまで改善要望の出現状況を示すものです。実際に施策へつなげる際は、満足度や利用頻度、継続利用意向などの定量データと組み合わせて確認します。
次のステップでは、分類コード別の件数だけでなく、満足度や利用頻度などの定量データと掛け合わせて、どの層にどの改善要望が多いのかを確認します。
4-6. 満足度や使いやすさ評価と掛け合わせて読む
自由記述回答を分類しカテゴリー化した集計結果を、他の選択式の設問の集計結果と関連付けて分析を深めていきます。
今回の調査事例では、以下の項目を選択式の設問で聞いています。
Q1.利用期間:1=1か月未満、2=1〜3か月未満、3=3〜6か月未満、4=6〜12か月未満、5=1年以上、6=2年以上
Q2.総合満足度:1=不満〜5=満足
Q3:使いやすさ評価:1=使いにくい〜5=使いやすい
Q4_1.利用機能:手入力(0=非利用、1=利用)
Q4_2.利用機能:レシート読み取り(0=非利用、1=利用)
Q4_3.利用機能:銀行・カード連携(0=非利用、1=利用)
Q4_4.利用機能:予算管理(0=非利用、1=利用)
Q4_5.利用機能:月次レポート・グラフ(0=非利用、1=利用)
Q5.継続利用意向:1=低い〜5=高い
Q6.推奨意向:1=低い〜5=高い
Q7.自由記述:改善してほしい点。()
これらの設問項目の回答内容ごとに、自由記述回答がどの程度出現しているかを以下の切り口から生成AIに数えさせてみます。
総合満足度:低満足者はどのカテゴリに不満を書いているか
使いやすさ評価:使いにくいと感じている人は、何を改善要望として挙げているか
継続以降:継続意向が低い人の不満はどこに集中しているか
推奨以降:人にすすめにくい理由と関係する不満は何か
利用機能:レシート読み取り、銀行・カード連携など、利用機能別に要望が異なるか
アンケート集計ソフト上の設定・操作やローデータのスプレッドシートを加工といった作業を生成AIに任せられることは大きなメリットです。
ローデータを読み込ませ、次のように指示します。
【プロンプト】
以下は、自由記述回答のローデータです。
回答ID、自由記述回答、修正後コード、総合満足度、使いやすさ評価、継続利用意向、推奨意向、利用機能を使って、分類コード別に定量データとの関係を整理してください。
条件:
分類コード別に、以下の項目を集計する
- 件数
- 総合満足度が低い回答者の件数と回答ID
- 使いやすさ評価が低い回答者の件数と回答ID
- 継続利用意向が低い回答者の件数と回答ID
- 推奨意向が低い回答者の件数と回答ID
各セルには、件数と該当する回答IDを併記する
回答IDはカンマ区切りで表示する
該当する回答がない場合は「0件(該当なし)」と表示する
件数と回答IDの数が一致しているか確認する
回答文に書かれていない内容は推測しない
・件数だけで改善優先度を断定しない
件数だけで改善優先度を断定しない
・表形式で出力する
表形式で出力する
上記のプロンプトに対する出力結果です。
件数の各セルに該当する回答IDも表示させています。それぞれの具体的な自由記述回答の内容を確認するためですが、IDとともに自由記述のテキストも別枠で表示するように指示すれば、確認作業も効率化できます。
分類コード | 全体の | 件数 | 総合満足度が低い回答者 | 使いやすさ評価が低い回答者 | 継続利用意向が低い回答者 | 示唆 | ||
画面・導線・設定の分かりやすさ | 15件 | 6件 | (ID:003, 014, 021, 038, 052, 067) | 10件 | (ID:003, 008, 014, 021, 029, 038, 044, 052, 067, 074) | 5件 | (ID:014, 021, 038, 052, 067) | 使いやすさ評価との関係が強い |
銀行・カード・決済連携 | 11件 | 5件 | (ID:006, 019, 033, 048, 071) | 4件 | (ID:006, 033, 048, 071) | 6件 | (ID:006, 019, 033, 048, 059, 071) | 連携機能の不満が継続意向に影響している可能性がある |
レシート読み取り・保存 | 9件 | 4件 | (ID:011, 026, 045, 062) | 5件 | (ID:011, 026, 045, 062, 076) | 3件 | (ID:026, 045, 062) | 日常的な入力負担に関係している |
動作速度・安定性 | 8件 | 6件 | (ID:004, 017, 027, 036, 055, 069) | 6件 | (ID:004, 017, 027, 036, 055, 069) | 5件 | (ID:017, 027, 036, 055, 069) | 件数は中位だが、低評価層に多い |
料金・プラン・広告 | 8件 | 2件 | (ID:024, 041) | 1件 | (ID:041) | 3件 | (ID:024, 041, 073) | 不満はあるが、使いやすさ評価とは直接結び付きにくい |
レポート・集計・グラフ | 7件 | 1件 | (ID:035) | 2件 | (ID:035, 064) | 1件 | (ID:035) | 継続利用意向が高い層の追加要望として出やすい |
上記の結果から以下のような示唆が得られます。
自由記述回答全体の集計では「画面・導線・設定の分かりやすさ」が最も多いカテゴリでした。使いやすさへの評価が低い回答者にも多く見られるため、操作導線や画面構成は改善候補として優先しやすい論点です。
「動作速度・安定性」は件数だけを見ると最多ではありません。ただし、低満足者や使いやすさ低評価者に集中している場合は、満足度を下げる要因として確認する必要があります。件数が中位でも、低評価と結び付いているカテゴリは、優先度が高くなることがあります。
「レポート・集計・グラフ」は、低満足者よりも継続利用意向が高い回答者から出やすい要望として整理できます。この場合、離脱防止のための緊急課題というより、継続利用者の満足度を高める機能改善として扱うほうが自然です。
このように、自由記述の分類結果を定量データと掛け合わせると、件数だけの比較では見えにくい差を把握できます。どのカテゴリの意見が多いかだけでなく、どの層に多いのか、どの評価項目と関係しているのかを確認することで、改善施策の優先順位を検討しやすくなります。
5. よくある失敗と対策
集めた自由記述を分類・集計し、定量データと結び付けるまでの工程で起こりやすい失敗と、その対策を整理します。
5-1. 分類の粒度や基準がそろわない
カテゴリの分け方に一貫した基準がないと、似た意見が別々のカテゴリに散らばったり、分けるべき論点が同じカテゴリに混ざったりします。
なぜ起こるか:分類コードを作る段階で、どの観点でカテゴリを分けるかを決めないまま回答を振り分けることが原因です。回答を読みながら手元でカテゴリを足していくと、粒度がばらつき、あとから重複や漏れが生じます。
対策:分類コードを確定する前に、粒度・重複・漏れ・複数論点の4点を確認の観点として決めておきます。1つの回答に論点が複数ある場合は、どれを主コードにし、どれを副コードに回すかをルール化します。
5-2. 生成AIの分類を検証せずに使う
生成AIが付けた仮コードを確認しないまま集計すると、誤分類が件数にそのまま反映されます。AIが回答文にない内容を補って分類する場合もあり、結果の信頼性が下がります。
なぜ起こるか:AIの出力が表形式で整っていると、中身を読まずに正しいと受け取りやすい点が背景にあります。生成AIは回答文の一部の語句を手がかりに分類するため、文脈を読み違える場合があります。
対策:AIの仮コードは下案として扱い、人が確認した修正後コードを集計の対象にします。集計をふたたびAIに任せる場合も、読み込ませるのは人が直した修正後コードに限定します。
プロンプトには、回答文に書かれていない内容は推測しない、件数と回答IDの数が一致しているか確認する、といった条件を加えます。件数の各セルに回答IDを併記させると、出力後に実際の回答内容を照合できます。
5-3. 件数の多さだけで優先順位を決める
出現件数が多いカテゴリを重要な課題と見なし、件数の少ない意見を軽視すると課題の優先順位を見誤ります。件数は論点の出現量を示すだけで、課題の深刻さと必ずしも一致しません。
なぜ起こるか:集計結果が件数の多い順に並ぶため、上位のカテゴリが優先課題のように見えることが原因です。件数が示すのは、その論点に何人が言及したかという出現量です。
一方で施策の優先度には、その課題がどの程度の影響を持つかという観点も関わります。件数の多さは、影響の大きさを直接表すものではありません。
対策:件数に加えて、影響度・対象層・改善可能性を判断の軸に組み合わせます。件数が少ない意見でも、低い満足度や解約意向と強く結び付いている場合は、優先的に検討すべき課題になります。
逆に件数が多くても、対応の影響が小さい論点や、すでに対策が進んでいる論点は、優先度を下げて判断します。件数の順位だけで結論を出さず、複数の軸を合わせて確認します。
自由記述分析・アフターコーディングに関するFAQ
Q:自由記述の回答件数が多い場合、どのように分析を進めればよいですか?
A:回答件数に応じて手法を使い分けるのが効果的です。50件程度までなら目視による精読や手動コーディングが最も正確ですが、数十〜数百件規模では生成AIを活用して「分類コードの下案作成」や仮ラベリングを行わせ、人の目で修正した後に集計するアフターコーディングが適しています。500件を超える大量データの場合は、頻出語分析や共起分析で全体像を俯瞰した上で、優先度の高いカテゴリを深掘りしていく進め方が現実的です。
Q:生成AIを使ってアフターコーディングを行う際、最も気をつけるべき注意点は何ですか?
A:AIが出力した仮コードを鵜呑みにせず、必ず人の目で確認・修正してから集計にかけることです。AIは回答文の一部の言葉だけを拾って文脈を誤読したり、書かれていない内容を推測して分類したりすることがあります。プロンプトで「本文にない内容は推測しない」「回答IDを併記させる」などの制約をかけ、人が修正したコードを最終的な集計対象とすることが品質担保の鍵となります。
Q:出現件数が多い意見から優先的に改善対応を進めればよいでしょうか?
A:件数の多さだけで優先度を決めるのは危険です。件数はあくまで言及された量を示すにすぎず、課題の深刻度と一致するとは限りません。たとえば件数は少なくても「低満足者」や「解約意向者」に集中している不満は離脱リスクに直結するため、緊急度の高い課題となります。件数(規模)に加えて、影響度(満足度や継続意向との関係)、対象層、改善可能性の4軸を組み合わせて優先順位を判断することが重要です。
6. まとめ:定性情報を意思決定の確かな根拠にするために
アンケートの自由記述回答は、数値だけでは見落とされがちな回答者の本音や具体的な背景、行動の文脈を深く捉えるための貴重な情報源です。
しかし、テキストの羅列のままでは客観的な判断材料として活用しにくいため、適切な手順で構造化していく必要があります。
自由記述を効果的に分析し、具体的な施策へと結び付けるための要点は以下の通りです。
件数と目的に応じた適切な手法の選択:回答の規模に合わせて目視と自動処理を使い分け、全体傾向の把握から背景の理解へと段階的にアプローチを組み合わせます。
定量データとの掛け合わせによる可視化:満足度や属性、行動データと自由記述の分類結果を交差させることで、課題を抱える対象層を特定しやすくなります。
多角的な視点を用いた優先順位の評価:言及された件数の多さだけでなく、満足度低下への影響度や改善の可能性など、複数の軸から取り組むべき施策を判断します。
分析の工程では、分類基準のばらつきや、生成AIの仮コードを検証せずに集計すること、件数の多さのみで重要度を断定することといった失敗が起こりやすくなります。AIによる作業の効率化を取り入れながらも、最終的な確認や文脈の解釈には人の目を介すことで、分析の信頼性と妥当性を確保できます。
アンケートに寄せられた生の声を単なる感想の羅列にとどめず、適切な手順で構造化して定量データと紐付けることで、次の施策を導く客観的な判断材料として活用できます。