 お問い合わせ
アンケート調査では、集計結果に表れた差が偶然のブレによるものなのか、判断材料として扱える差なのかを見極める必要があります。そのために使われるのが有意差検定です。
ただし、有意差検定は万能な判断基準ではありません。p値が小さいことは、差が偶然だけでは説明しにくいことを示しますが、その差が施策上重要であるか、調査対象全体にどこまで広げて解釈できるかは別に確認する必要があります。
本記事では、標本誤差・標準誤差・p値・有意差の関係を整理しながら、ビジネス目的のアンケート調査で検定結果をどう読むべきかを解説します。
この記事でわかるアンケート集計結果を正しく理解するための基本
アンケート結果に生じる偶然のブレ「標本誤差」と、サンプルの偏りや設問不備による「非標本誤差」の違い
ブレを測るものさし(標準誤差)から、差が偶然出る確率(p値)を導き出す有意差検定の仕組み
p値が「5%以下」であることの統計学的な正しい意味と、よくある解釈の誤解
「統計的な有意差」と「ビジネス施策における重要度(対応する価値)」を切り分けて判断する視点
事前の仮説検証、後からの探索的な発見、大量のクロス集計(多重比較)による検定結果の重みの違い
登録モニター(非確率抽出)を用いたビジネス調査において、結果の射程を誤らず安全にデータ活用するコツ
1. アンケート結果の差はどこまで信頼できるのか
アンケート調査の集計を行い、Aを選んだ人が60%、Bを選んだ人が40%だったとします。同じ「60%対40%」でも、10人に聞いた6人と4人なのか、1,000人に聞いた600人と400人なのかで、数字の見方は大きく変わります。
10人の場合、AとBの差は2人です。この差は、たまたまAを選ぶ人が少し多く混じっただけかもしれません。一方、1,000人の場合の200人差は、もう一度同じ調査をしても同じような差が出ると考えてよさそうです。
さらに、1,000人に聞いた600人・400人は、別の1,000人に聞いたとすると、AとBが逆転するほどの違いは生じないとしても、数人、あるいは数十人の範囲でブレることが考えられます。このように、どの人がたまたま回答者に選ばれたかによって結果が少しずつ動く性質を標本誤差(サンプリング誤差)といいます。
標本誤差は回答人数が少ないほど大きく、多いほど小さくなります。10人の2人差は誤差に埋もれてあてにならず、1,000人の200人差は偶然のブレでは説明しにくい、確かな差だと考えます。
この時、結果として得られた差が、偶然だけで生じうる範囲を超えているかどうかを確かめる手続きが検定であり、超えていると判定された差を有意差といいます。
1-1. ブレの正体 ー 標本誤差と非標本誤差
アンケート調査のなかで誤差として生じるブレは、標本の抽出の仕方によって生じる標本誤差とそれ以外の要因で生じる非票本誤差の2つに分けられます。
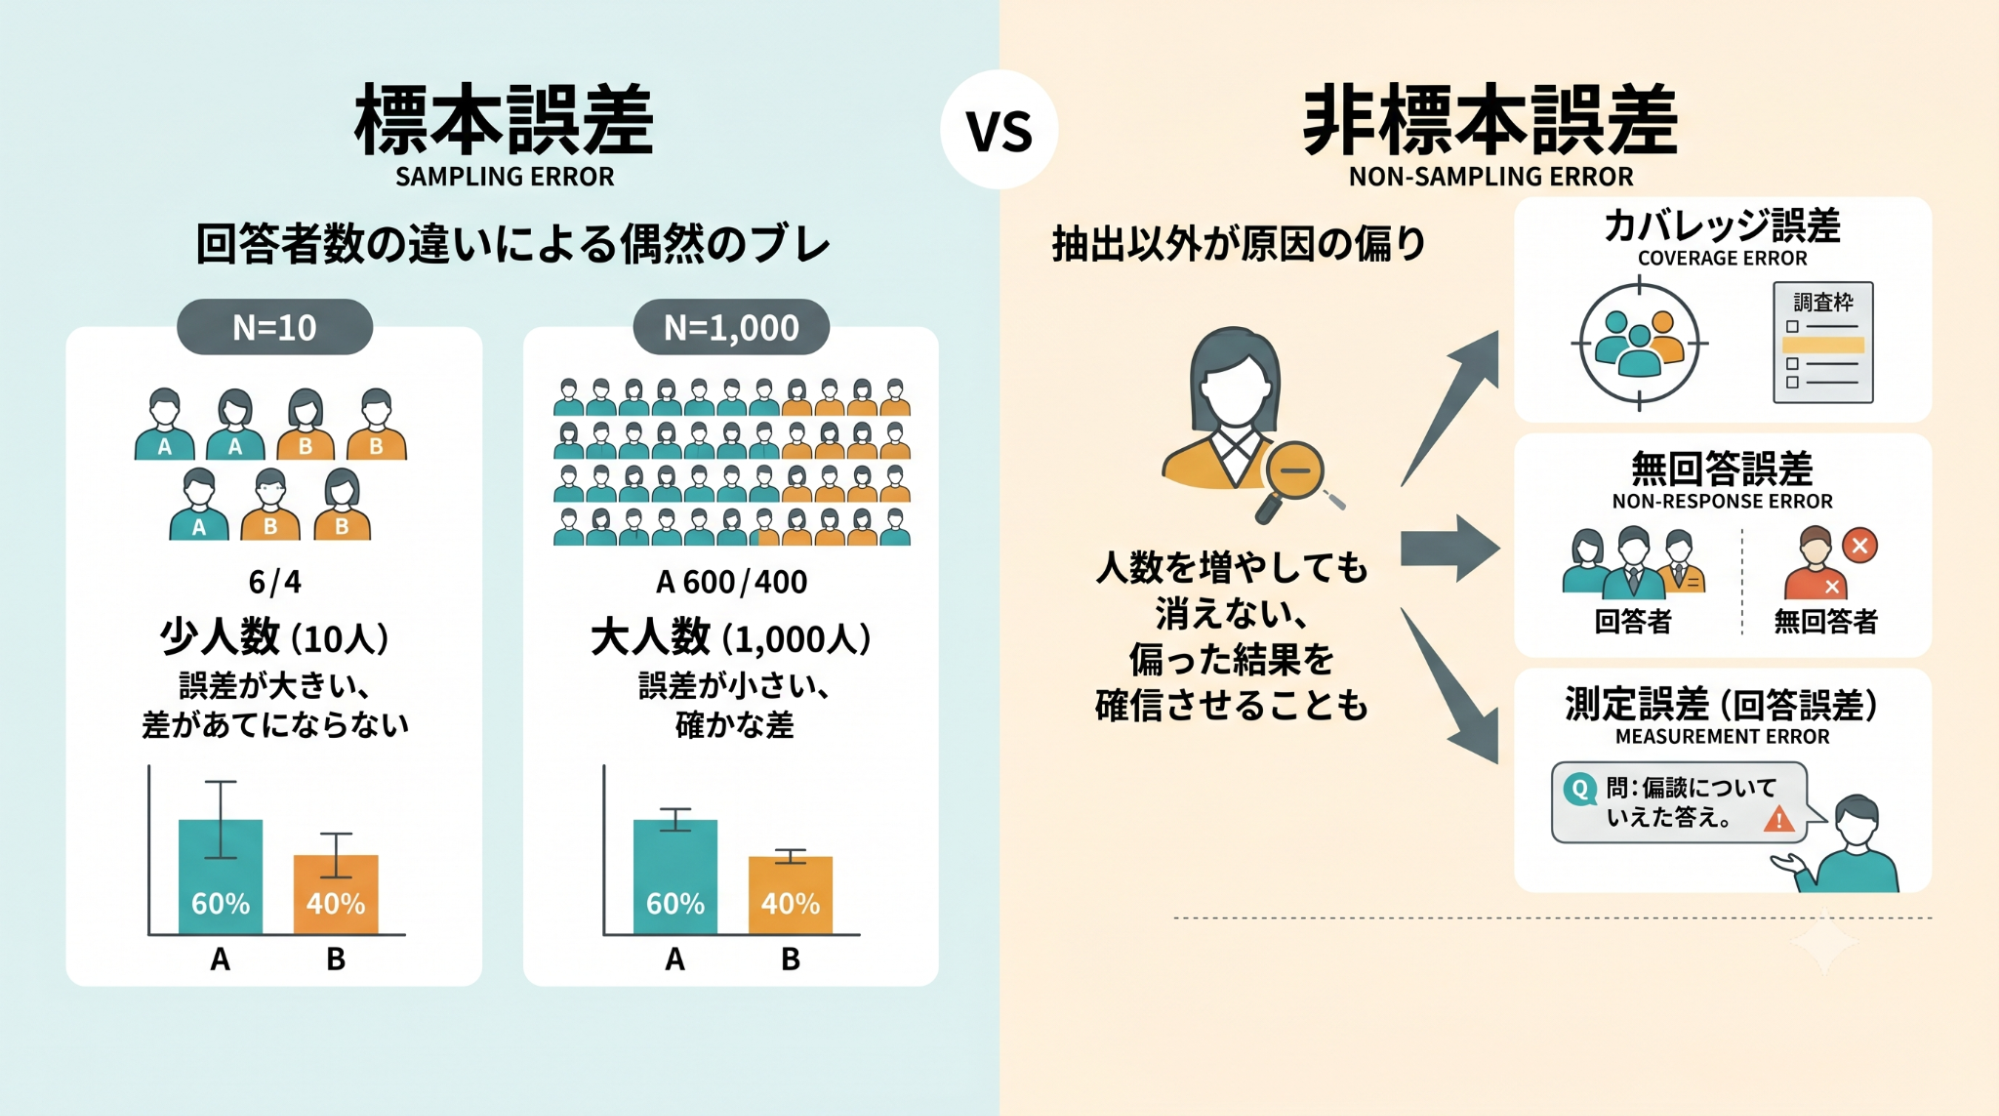
標本誤差と非標本誤差の違いを把握しておくことが重要です。検定が対象とするのはあくまで偶然生じる標本誤差の範囲に限られます。
一方、サンプルの偏りや設問の不備といった非標本誤差については、統計的な計算とは異なる視点からその妥当性を検討する必要があります。
2. その差がブレを超えているかを確かめる
手元のデータに現れた差が、偶然のブレ(標本誤差)の範囲に収まるものなのか、それともそれを超えたものなのかを判断するために、散らばりの幅をベースにしたものさしを使用します。
その判定の基準となる具体的な仕組みと、そこで使われる指標について解説します。
2-1. 検定はブレをものさしにする
同じ調査でも回答者が異なれば結果が変動してしまう偶然のブレのことを標本誤差と説明しましたが、このブレの大きさを数値化したものが標準誤差です。標準誤差は標本誤差を測る「ものさし」として考えるとわかりやすいです。
仮に、AとBに本当は差がなかったとしても(この仮の前提を、帰無仮説と呼びます。)、現実には回答者が変わるたびに、測られる差は0ちょうどにはならず、0を中心に山なりに散らばります。
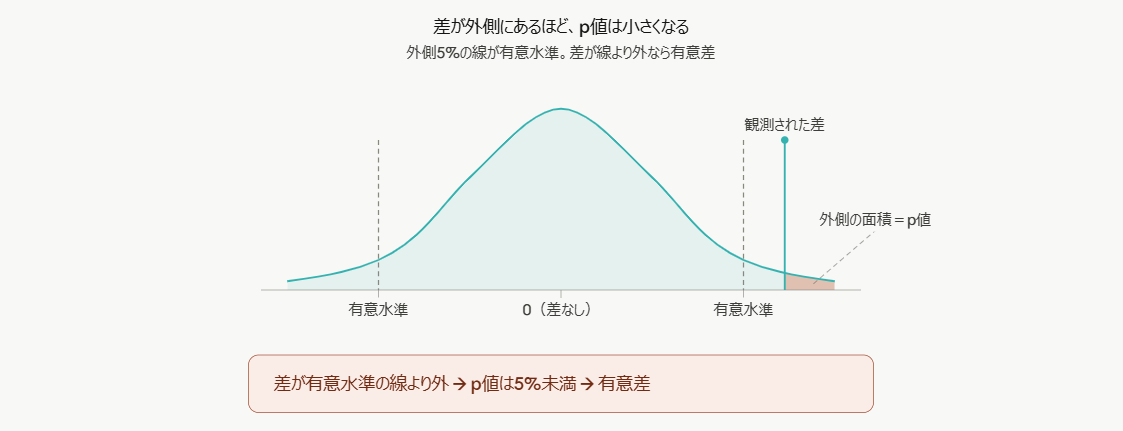
この散らばりの幅が標準誤差で、以下の図の1目盛りにあたります。測られる差の多くは、中心から1目盛り分の範囲に収まります。
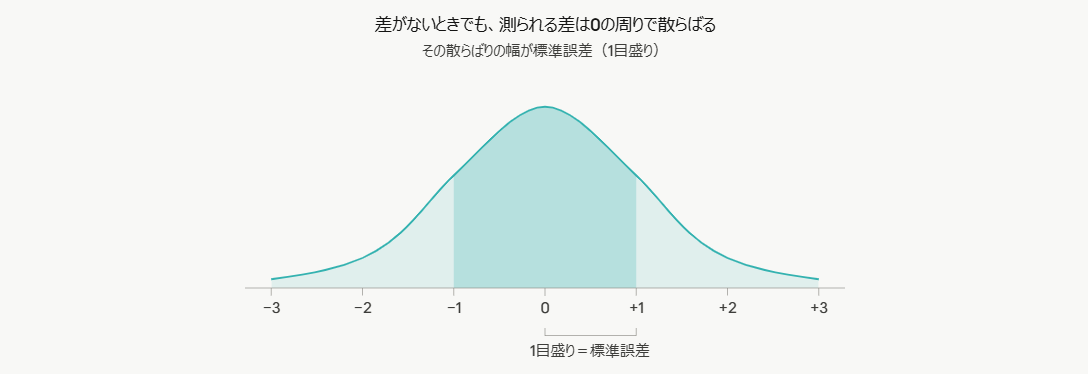
次に、実際に観測された差を、この山の上に置いてみます。中心に近い1目盛り程度の差なら、山の厚い部分にあたり、差がないときでもよく起こります。2目盛り、3目盛りと外側へ離れるほど山は薄くなり、差がないのにそこまで離れることはまれになります。
このとき、観測された差より外側に残っている山の面積 ( 差がないとしても、これ以上の差が偶然出てくる確率 ) がp値です。差が外側にあるほど、この面積は小さく、p値も小さくなります。
最後に、どこまで外側なら偶然では説明しにくいと判断するか、という基準が必要です。慣習では、山の外側5%にあたる位置に線を引き、これを有意水準とします。
観測された差がこの線より外側にあれば、p値は5%を下回り、偶然では説明しにくい差、すなわち有意差があると判断します。
標準誤差で山の幅を決め、差の位置から外側の面積をp値として読み、有意水準の線と比較する ― というのが一連の手順です。より詳しい解説は有意差検定とはをご覧ください。
2-2. p値の正しい読み方:5%の意味とは?
よくある誤解が、p値が5%なら、差がない確率が5%(=95%の確率で差がある)という解釈です。実は、これはp値の意味とは違います。
p値は、手元のデータを見たあとに差がある確率を計算しているものではありません。 出発点は、あくまでも「差はない」という仮定です。
わかりやすくするために、コインの裏表で考えてみます。 コインを10回投げて、10回とも表が出たとします。このとき私たちが考えるのは、次のような順番です。
まず前提を置く: 「このコインは普通のコイン(表裏の確率は半々)だ」と仮定する。
確率を計算する: もし普通のコインなら、10回連続で表が出る確率は約0.1%しかない。
前提を疑う: 「0.1%なんて滅多に起きない。ということは、普通のコインだという最初の前提のほうが怪しい(仕掛けがあるはずだ)」と結論づける。
p値も同じ考え方です。p値が5%ということは、「もし本当に差がないとしたら、今回観測された結果と同じか、それ以上に極端な結果が出る確率が5%である」という意味です。
p値が小さいときは、差がないという仮定のもとでは起こりにくいデータが得られたため、その仮定を疑う根拠になる、ということです。
2-3. 有意差ありは意味のある差ではない
有意差は日常用語の意味があるとは異なり、その差が偶然のブレだけで起きたとは考えにくいという事実を示しているにすぎません。
注意しなければならないのは、統計的に有意であることと意思決定や施策において対応する価値があることは別問題だという点です。
検定は、差が偶然生まれたものかどうかを判定しているだけであり、その差の大きさがどれほど重要かを評価しているわけではありません。
例えば、サンプルサイズ(データ数)が非常に大きい場合、現場の感覚としては無視できるほどごく僅かな差であっても、検定結果は有意差ありと判定されることがあります。
得られた差が偶然ではないと分かった次のステップとして、それが自社にとってコストや労力をかけて追うべき価値のある差なのかを、ビジネスの視点から人間が判断する必要があります。
データの特徴や比較したい内容によって、用いる検定手法は以下のように異なります。
平均値の差を比べる場合: 満足度スコアや売上単価などの平均値を比較する際は、主にt検定が用いられます。
割合(比率)の差を比べる場合: クロス集計における男女の購入比率など、構成比に違いがあるかを見る際は、主にカイ二乗検定が用いられます。
3. 有意差を見るときは、何を比較したのかまで確認する
検定結果を見るときは、有意差があるかどうかだけで判断しないことが大切です。同じ有意差ありの結果でも、次のどの文脈から導き出されたかによって、その情報の重みが変わるからです。
事前仮説の検証: 調査設計の段階で設定していた仮説を裏付ける結果か
探索的な発見: データの集計過程で偶然浮かび上がった予期せぬ差異か
多重比較の産物: 膨大なクロス集計の繰り返しの中から抽出されたものか
主要KPIの比較: 意思決定に直結する重要な指標に絞った比較結果か
特に注意が必要なのは、データの集計表をいくつも眺めたあとに、特定の属性だけで差が見つかったようなケースです 。比較する回数が増えるほど、確率論的に「たまたま偶然生じたブレ」を統計的な有意差として誤認するリスクが蓄積されていくためです。
この問題を多重比較と呼びます 。有意差の過大評価を防ぎ、正しく判断材料として活用するために、それぞれの文脈に応じた解釈のポイントを押さえておきましょう。
3-1. 事前に決めた仮説の検証なら、結果として扱いやすい
調査前から確認したい仮説が決まっている場合、その分析結果は調査の信頼性を担保する有力な根拠となります。具体的には、以下のような比較が挙げられます。
顧客属性による満足度の違い: 新規層とリピート層の間で評価に乖離が見られるか
性別による意向の差異: 男女間で商品の購入意欲に明らかな隔たりがあるか
世代別の認知状況: 若年層と中年層でブランドの浸透率に有意な差が存在するか
比較軸や指標を事前に絞り込んでおけば、得られた検定結果を仮説の成否を分ける判断材料としてスムーズに活用できます。有意差が出なかった場合は、今回の調査では、想定していた差を確認できなかったと考えます。
ただし、有意判定の有無のみで結論を急ぐのは危険です。その差がわずか数ポイントなのか、それとも10ポイント以上の大きな開きなのかによって、ビジネス上の意思決定における重要度は全く異なるためです。
3-2. 後から見つけた差は、探索的な結果として扱う
集計作業を進めるなかで、当初の想定にはなかった結果がでることもあります。
たとえば、年代別の比較を目的としていたものの、結果を見ると利用頻度の高い層で満足度が突出していることが判明した、といったケースです。
こうした予期せぬ発見は、新たなターゲット層の特定や次なる深掘りテーマの示唆を得るという点で、調査における重要な成果といえます。
ただし、後から見出された差については、事前に設定していた仮説検証と同等の確信を持って扱うことはできません。膨大なクロス集計を繰り返すなかで、偶然生じただけのブレを拾い上げているリスクを否定できないからです。
そのため、後から見つけた有意差は、探索的な結果として表現します。
具体的には、「今回の分析では高頻度利用層の満足度が高い傾向が確認されたが、事前の検証項目ではないため、次回の調査でその再現性を改めて確認する必要がある」といった補足を行います。
結論として断定するのではなく、次に検証すべき仮説として扱うのがポイントです。
3-3. 大量のクロス集計では、多重比較の影響を明記する
アンケートでは、性別や年代、居住地域、職業、あるいは利用の頻度や購入経験の有無といった、さまざまな属性によるクロス集計が実施されます。
さらに、満足度、購入意向、継続意向、認知率など、複数の指標を組み合わせると、比較の数は一気に増えます。
比較の数が増えるほど、どこかで偶然に有意差ありと判定される可能性も高くなります。これが、多重比較の問題です。
特に注意したいのは、大量のクロス集計表の中から、有意判定が出た項目のみを抽出して強調するようなケースです。読み手には特定の属性に確かな違いがあるかのように映りますが、実際には多数の試行のなかでたまたま目立った「偶然のブレ」を拾い上げているにすぎない可能性があるからです。
この場合も、後から見つけた差と同様に参考情報として補足を明記します。
3-4. 主要KPIだけの比較は解釈しやすい
あらかじめ重要なKPIに絞って比較する場合は、結果を比較的解釈しやすくなります。
具体例として、プロモーション施策の有効性を測定する調査では、以下のような指標が主要KPIの対象となります。
ブランド認知率
広告認知率
購入意向
ブランド好意度
CS調査(顧客満足度調査)であれば、全体的な満足度や今後の継続利用意向、他者への推奨意向などがこれに該当します。
注目すべき指標を事前に定義しておけば、膨大な集計データの中から偶然現れた都合のよい差異だけを恣意的に抽出するリスクを低減でき、調査の本来の目的に直結しているため、有意差が持つビジネス上の意味合いも明確になります。
その一方で、主要KPI以外の細かな項目まで深掘りして確認する場合は、解釈のウェイトを分けて考えるのが適切です。
一例を挙げると、最重要指標である購入意向とする場合は「広告接触群と非接触群の間で有意な差が認められた」と結論づける一方で、その他の属性別クロス集計については、あくまで参考値として整理し、将来的な仮説立案のための素材として活用する、といった使い分けです。
主要なKPIとそれ以外の参考指標を明確に区分することで、分析結果のなかで真に重視すべきポイントが浮き彫りになります。
4. 何のための調査かに立ち返り、結果の射程を見極める
ここまで解説した統計学的な手法は、本来、母集団から無作為に選んだ標本を前提に構築された理論です。これをビジネスに応用する前に、立ち止まって考えるべき点があります。
それは、調査の本来の目的は何であるか、という問いです。多くのビジネスリサーチにおいては、母集団の正確な値を言い当てることを目的にしていません。その目的に照らし合わせた結果の読み方のほうが重要になってきます。
4-1. 意思決定のための調査は「真値の特定」ではない
定量調査の目的は、大きく次の2つの方向に分類できます。
母集団の値を精密に推定する:世論調査や政府の標本調査のように、「日本全体ではどうか」を一定の精度で当てることを目的とするものです。この精度が要る場面は、公的な調査や政策判断など、実は限られています。
具体的な意思決定を支える:一般的なビジネス調査の多くはこちらに該当します。知りたいのは全体の真の値そのものではなく、想定しているターゲット層において、施策を推進するに足る確かな差があるかということです。
ここで誤解しないでおきたいのは 、ビジネス調査であっても本質的には推測を行っているという点です。回答者個人を分析するのではなく、その背景にある「特定の属性を持つ人々」の傾向を把握するために調査を実施します。
両者の違いは、想定する対象範囲の広さと、許容される精度のレベルにあります。ビジネスでは、対象が日本全体である必要はなく、自社の顧客像やターゲット層といった、もっと狭い範囲に限定されます。
ビジネス領域の調査では、公的統計のような厳密さは求められないことがほとんどであり、射程を絞った推測を行っている、と捉えると整理しやすくなります。
4-2. 登録モニター調査は非確率抽出である
セルフ型アンケートツールの登録モニターを使うことで、調査に必要なだけのサンプル数を短時間・低コストで集めることができます。
調査の枠組みという点では、セルフ型アンケートツールの登録モニターには以下のような特性があります。
自己選択の介在:モニターは自発的に登録した人々であり、母集団から機械的にランダム抽出されたわけではありません。
カバレッジの偏向:インターネット環境を使い、特定のパネルに属している層に限定されます。未登録の層は最初から対象に含まれません。
割付の限界点:性別や年代を人口構成に近づける割付は可能ですが、これは見かけの構成を整えるだけで、無作為抽出が持つ偶然の公平性までは再現できません。
登録モニターを対象とした調査は確率抽出ではなく非確率抽出に分類されます。これは手法の性質を指すものであり、それ自体が良し悪しを意味するものではありません。
4-3. 理論上の精度と解釈のずれ
標準誤差というものさしは、母集団から無作為に人を選び、それを何度も繰り返した際のブレを前提に目盛りが作られていると説明しました。
非確率抽出ではこの前提が成り立ちません。 ただ、その影響が及ぶ範囲は限定的です。具体的には、標本の結果から日本全体の絶対値を精密に推定し、その誤差幅をそのまま適用しようとする読み方です。
これは公的な調査が目指す方向であり、無作為抽出が前提であるため、非確率抽出ではその根拠が弱まります。
ビジネスにおける意思決定においては、もともとそこまでの厳密な精度を目的としていないことが多いため、非確率抽出であることが調査の意義を薄めたり、調査の目的を達成できないということではありません。
ただし、登録者の特性による偏りは標準誤差では算出できないため、検定が対象とするのは標本誤差だけです。非標本誤差は最初からその守備範囲の外だからです。サンプルを増やしても、この偏りは消えません。
4-4. 「調べた人たちのなかの差」として読めば、指標はそのまま使える
これらの点を踏まえれば、登録モニターを対象とする調査においても検定は有効な指標となります。重要なのは、結果を一般化する範囲を市場全体ではなく「今回調べた回答者」にとどめることです。これは、意思決定を目的とするビジネス調査のもともとのスタンスです。
特に、性別や利用頻度によるグループ間の比較(相対比較)は、ビジネスの意思決定においては非常に有用です。「もしグループ間に差がないとすれば、これほどの違いは偶然では起きにくい」という問いは、調べた回答者の範囲内で完結するからです。
注意したいのは、 結論を述べる際に対象範囲を無意識に広げてしまうことです。
✕ 広告接触層の意向は、市場の一般消費者全体において高い
○ 今回調査したモニターの中では、広告接触層の意向に(偶然のブレを超えた)有意な高まりが見られた
前者は、当初の目的を超えて母集団への一般化を行ってしまっています。後者のように、結論の表現を調査の実態に合わせて調整することが、データを正しく意思決定に活かすための鍵となります。
「偶然のブレを超えているか」「どのような文脈での比較か」、そして「どこまでの範囲に言える差か」。この3つの視点を統合することで、有意差の結果を安全な判断材料として扱うことが可能になります。
アンケート結果の有意差に関するFAQ
Q: 有意差検定の判定基準でよく見る「p値が5%以下(p<0.05)」とは、95%の確率でその差が本物という意味ですか?
A: いいえ、それはよくある誤解です。p値は「手元のデータを見たあとに差がある確率」を示しているわけではありません。「本当は差がない」と仮定したときに、たまたま今回のように極端な結果(差)が偶然生じる確率が5%以下である、という意味になります。つまり「差がないと考えるには無理がある(偶然では起きにくい)」と判断して最初の仮定を疑うための統計的な根拠です。
Q: 検定結果で「有意差あり」と出たデータであれば、ビジネスにおいて無条件で信じて施策を進めてよいのでしょうか?
A: いいえ、統計的に有意であることと、ビジネス施策において対応する価値がある(意味がある)ことは別次元の問題です。とくにサンプルサイズ(回答数)が非常に大きい調査の場合、実務上は無視できるようなごく僅かな数値の差であっても「有意差あり」と判定されることがあります。その差がコストや労力をかけて追うべき価値があるものなのかは、人間が判断する必要があります。
Q: クロス集計表を何枚も作成し、後から「有意差が出た項目」だけをピックアップしてレポートをまとめても問題ありませんか?
A: 注意が必要です。大量のクロス集計を繰り返す(試行回数を増やす)ほど、確率論的に「たまたま偶然生じたブレ」を統計的な有意差として誤認するリスクが蓄積されます(多重比較の問題)。事前の仮説にない「後から見つけた差」や「大量のクロス表のなかから見つけた差」については、結論として断定せず、あくまで参考情報や、次回の調査で検証すべき「新たな仮説」として扱うのが適切です。
5. まとめ
検定は、主観的な思い込みを排除し、確率に基づいた客観的な視点から意思決定を下すための強力な判断材料となります
ここまで解説してきた、検定の本質的な役割と向き合う際の重要な論点を整理します。
有意差が意味する「偶然の否定」
「差は存在しない」という前提のもと、観測されたデータが単なる偶然のブレ(標本誤差)だけで説明するには無理がある、という事実を浮き彫りにする手続きです。統計的有意性とビジネス価値の切り分け
確率論的に有意であっても、それが実務上のコストや労力を投じるに値する重要度を持つかは別次元の話です。最終的な評価は、ビジネスの文脈から人間が行う必要があります。比較プロセスの背景確認
当初からの仮説検証なのか、膨大な集計の中で偶然捉えた多重比較の産物なのか。どのような文脈で導き出された差であるかによって、情報の信頼性や解釈の重みは大きく異なります。調査手法の限界をふまえた適切な解釈
登録モニターを対象とした非確率抽出の調査では、過度な一般化を避け、「今回の回答者における確かな差異(相対比較)」として読み解くことが、安全なデータ活用に繋がります。
このように、数値の背後にある確率的なメカニズムとビジネスの背景を正しく噛み合わせることで、データの偏りや限界を補い、調査結果が持つ真の価値を意思決定に引き出すことが可能になります。