 お問い合わせ
さまざまな統計データを見る際、平均値はデータ全体の傾向を端的に把握するための基本的な指標です。しかし、一つの数値として示されるため、数値の高低だけを根拠に意思決定を行うと、データのばらつきや偏りを見落とし、本質を見誤るおそれがあります。
本記事では、平均値を正しく解釈するために必要な基礎知識から、具体的な確認プロセス、さらに判断を誤りやすい典型的なケースとその回避策までを体系的に解説します。
この記事でわかること
平均値が持つ「大量のデータを1点に要約する」便利さと、情報の削ぎ落としというトレードオフ
同じ平均値でも実態が全く異なる「二極化」など、回答分布(ばらつき)を確認する重要性
算術平均が特定のヘビーユーザーや高額回答などの「外れ値」に引きずられるリスクと、その対策
- 回答数(サンプルサイズ)の少なさや、回答者構成の偏りが平均値の信頼性に与える影響
回答数(サンプルサイズ)の少なさや、回答者構成の偏りが平均値の信頼性に与える影響
- 施策の前後比較で平均値に差が出た際、属性構成の変化に騙されず正しく因果関係を読み解く手順
施策の前後比較で平均値に差が出た際、属性構成の変化に騙されず正しく因果関係を読み解く手順
1.導入
グループごとの構成比の偏りを考慮しない全体平均は、実態とはまったく異なる結論を導くことがあります。
たとえば、ある新薬の臨床試験で、全体としては新薬の治癒率が既存薬よりも高いという結果が出たとします。しかし、患者を男女別に分けて分析すると、男性患者・女性患者ともに既存薬の方が治癒率が高い結果が示されるといったケースがあります。
カテゴリ | 新薬(グループA) | 既存薬(グループB) | 勝者 |
男性患者 | 10%(1/10人) | 15%(15/100人) | 既存薬 |
女性患者 | 60%(60/100人) | 70%(7/10人) | 既存薬 |
全体(合計) | 55.5%(61/110人) | 20%(22/110人) | 新薬 |
上の表の数値は極端な例ですが、全体を集計した結果と、属性別に分けた結果が真逆になる現象はシンプソンのパラドクスと呼ばれます。これは、グループごとの分母(サンプル数)の偏りを見落とすことで発生し、データを大雑把に丸めてしまうことの危うさを物語っています。
平均値は、大量のデータを一つの数字に集約する過程で、その背後にある重要な情報、たとえばデータの分布、回答者の構成、外れ値の有無などを見えにくくします。このため、平均値の数字だけを見て意思決定を下すと、実態とかけ離れた結論を導き出してしまうリスクがあります。
本記事では、平均値が何を見せて何を隠しているのかという性質を整理し、データの実態を正しく読み解くための具体的な確認手順と、マーケティング場面での実践的な解釈方法を順を追って解説します。平均値を単なる「結論」ではなく、データを深掘りするための「入口」として活用する視点を身につけましょう。
2. 基礎知識(前提となる考え方)
平均値の数字を正しく解釈するには、その指標がどのような性質を持ち、どこに限界があるかを押さえておく必要があります。ここでは、平均値そのものが持つ性質と、アンケート特有の論点を整理します。
2-1. 平均値は分布を1点に要約する指標
平均値(算術平均)はデータの重心を示すという特徴を持っています。シーソーの真ん中に置けば左右が釣り合う点、と言い換えてもよいかと思います。
平均値の最大のメリットは、大量のデータを1つの数値に代表して表現できる利便性にあります。しかし、この利便性はもとの分布が持っていた情報を捨てる、というトレードオフのうえに成り立っています。
1つの数値に要約する過程で、回答のばらつきや、極端な回答の存在といった重要な情報が削ぎ落とされます。この限界を補うための代替指標として、データを順に並べた中央の値を指す中央値や、上下の極端な値を一定割合除外して計算するトリム平均があります。
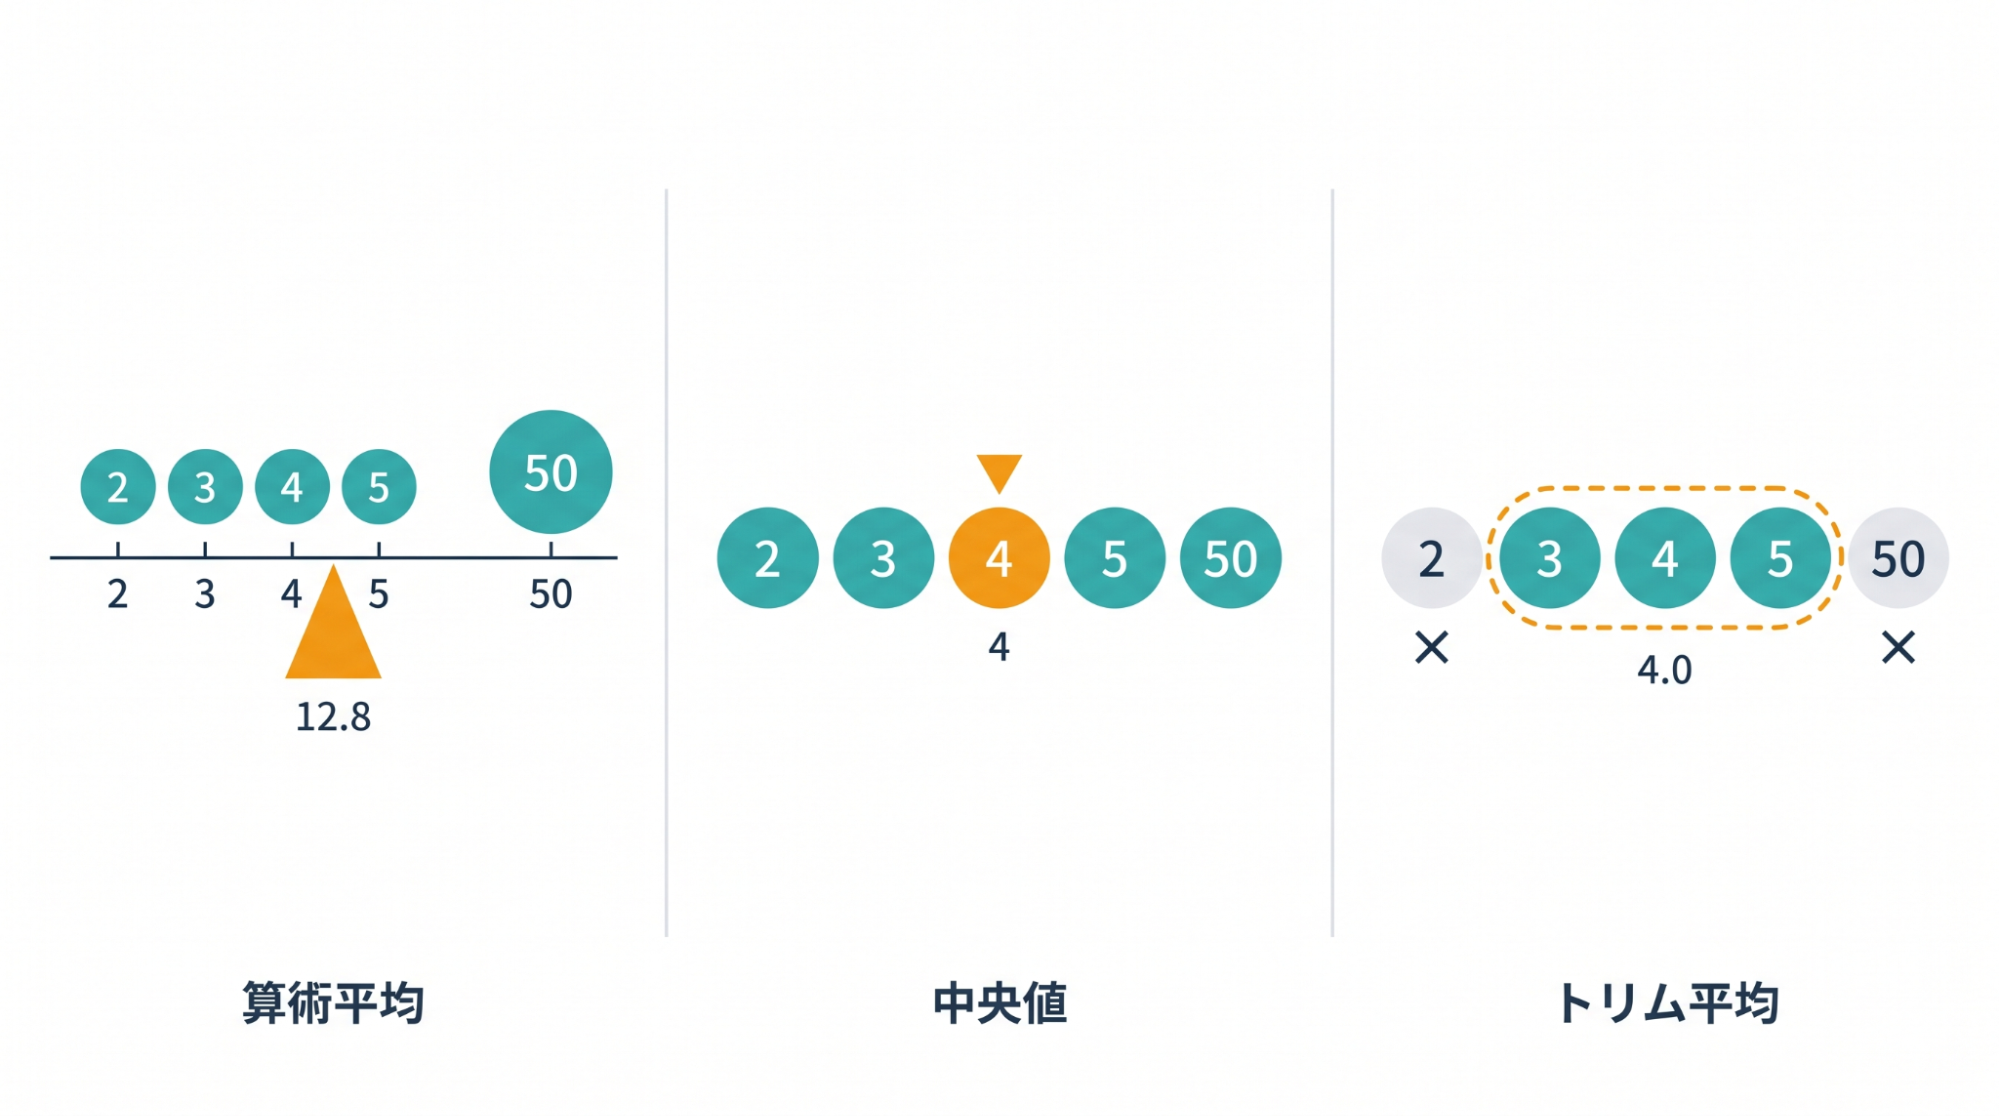
算術平均:合計 ÷ 回答数。一般的に「平均」と呼ぶ値。全データを反映するため、外れ値の影響を受けやすい
中央値:値を昇順に並べたときの中央の値。外れ値の影響を受けにくい
トリム平均:上下一定割合を除外したうえで算術平均を取った値。算術平均と中央値の中間的な性質
中央値とトリム平均は、外れ値が含まれるときに算術平均を補う代替指標として位置づけられます。なお、分布の中心を示す指標としては最頻値(最も多く現れた値)もありますが、本記事では平均値とその代替という観点で算術平均・中央値・トリム平均を挙げています。
2-2. 平均値が「捨てている」情報
平均値という1つの数字は、もとの分布が持っていた情報を失ってしまっています。代表的なものは「ばらつき」「外れ値の影響」「欠損値の扱い」の3つです。
2-2-1. ばらつきは見えない
同じ平均値でも、回答がどう散らばっているかは平均値からは読み取れません。5段階評価で平均3.0という結果が出たとしても、その内訳は1通りではありません。
回答パターン | 1点 | 2点 | 3点 | 4点 | 5点 | 平均 |
A:全員が中央 | 0% | 0% | 100% | 0% | 0% | 3.0 |
B:山型 | 10% | 20% | 40% | 20% | 10% | 3.0 |
C:二極化 | 50% | 0% | 0% | 0% | 50% | 3.0 |
Aは全員が「どちらでもない」と回答した状態で、強い評価を持つ人は誰もいません。Cは熱狂的な支持層と否定層が真っ二つに分かれた状態で、平均だけ見るとどちらも中立に見えますが、中身はまったく異なります。打ち手も当然変わってきます。平均値はこの違いを区別しないという性質を持っています。
2-2-2. 外れ値の影響を受けやすい
算術平均は全データの合計を用いるため、極端な値がひとつ混ざるだけで大きく動きます。購入金額・利用回数・閲覧時間といった数値回答では、上振れの外れ値が発生しがちです。
回答者 | A | B | C | D | E | 平均 |
通常 | 1,000円 | 1,200円 | 900円 | 1,100円 | 1,000円 | 1,040円 |
1人だけ高額 | 1,000円 | 1,200円 | 900円 | 1,100円 | 50,000円 | 10,840円 |
5人中4人は1,000円前後の購入なのに、平均は1万円超えになります。算術平均は外れ値に引きずられる性質があり、こうした分布では実態から離れた値が出やすくなります。
2-2-3. 欠損値・無回答の扱いで値が変わる
アンケートでは、回答のスキップや未入力による欠損値(無回答)が含まれるケースがあります。無回答をどう扱うかでも平均値は変動します。一般的な処理の方法としては次の2つです。
有効回答のみで計算(リストワイズ削除)
欠損のある回答者を最初から除外して平均値を出す
存在するデータのみで計算するため、回答した人の平均は正確に出るが、未回答が多いと全体の代表性が落ちる
特定の数値で穴埋めして計算(代入法)
無回答を「0」や「全体の平均値」などの値とみなして補完する
分母を維持できるが、実態とは異なる仮の数値が混ざるため、平均値が本来の意味から歪むリスクがある
どちらも一定の理由があり、唯一の正解はありません。ただし、選び方そのものによって平均値の数字が変わるという性質は前提として押さえておくべき点です。
2-3. 平均値は「どう得たか」に依存する
平均値は計算式上はシンプルですが、それを支えるデータの集め方(回答数や回答者の構成)によって数字の重みは変わります。
2-3-1. 回答数(サンプルサイズ)による信頼性の違い
平均値の安定性は、集計対象となる回答数(サンプルサイズ)の規模に左右されます。回答数が少ない状態では、偶然紛れ込んだ1人、2人の特異な回答によって平均値が上下に激しく変動しやすい傾向があります。
回答数の規模 | 平均値の挙動 | データの信頼性 | |
回答数が少ない | (n=10など) | 1人の回答の変化で数値が大きくブレる | 偶然の要素が強く、真の実態を反映しているか不確実 |
回答数が多い | (n=500など) | 個人のブレが相殺されて数値が安定する | 誤差が小さくなり、集団の本来の傾向に近づく |
統計学では、得られた平均値にどの程度の誤差が含まれるかを示す指標として標準誤差が使われます。回答数が少ないほど標準誤差は大きくなり、平均値の信頼度は低下します。また、この誤差の範囲を考慮して、真の平均値が位置する幅を確率的に示したものを「信頼区間」と呼びます。
2-3-2. 回答者構成の偏りで代表性が崩れる
アンケート全体の回収数が十分に多くても、回答者の属性割合(性別・年代・会員ランクなど)が実際の顧客ターゲット層の構成比から離れている場合、得られた平均値は全体の代表性を失います。
例えば、実際の顧客比率が「男性20%:女性80%」のサービスにおいて、アンケート回答者が「男性50%:女性50%」で集まったとします。この場合、男性の意見が過剰に反映された平均値が出力されます。
こうした回収の偏りを補正し、実際の顧客構成比に合わせるように回答の重み付けを変えて平均値を再計算する手法をウェイトバック集計と呼びます。
2-3-3. 標本平均と母平均は別
調査で得られる平均値は、あくまで「回答してくれた人」の平均値(標本平均)です。本当に知りたいのは想定ユーザー全体の平均(母平均)である場合、両者は必ずしも一致しません。
標本平均は母平均の推定値である、という関係を意識しておくと、平均値の数字を絶対視せずに済みます。
2-4. アンケート特有の2つの論点
アンケート集計で平均値を扱う際に意識しておきたい論点を2つ整理します。
2-4-1. 5段階評価を量的変数として扱ってよいか
顧客満足度などで多用される「大変満足(5点)〜大変不満(1点)」のような5段階の選択肢は、本来は順序のみに意味がある質的変数(順序尺度)です。
1点と2点の間の心理的距離と、4点と5点の間の心理的距離が等しいとは限らないため、厳密な統計学の定義では、これらを足し引きして平均値を求めることは不適切とされます。
しかし、マーケティングの現場においては、これらの選択肢を量的変数(間隔尺度)とみなして平均値を算出する立場が広く採用されています。指標が1つの数値にまとまることで、過去データや他セグメントとの比較が非常にスムーズになるためです。
このアプローチをとる場合、平均値は全体の好意度の方向性を示す目安として扱い、同時に各選択肢の割合(%)も併記してデータの構造を補う形が一般的です。
2-4-2. 割合は0/1データの平均値である
アンケートで頻出する「認知率」「購入経験率」「推奨意向の有無(Yes/No)」といった割合(%)は、実は平均値と全く同じ構造を持っています。
Yesを「1」、Noを「0」としてデータ化すると、その平均値はパーセンテージと完全に一致します。
回答データを0と1に置き換えた場合の平均値計算
回答者 | 認知しているか(選択肢) | 0/1 変換データ |
回答者A | 認知している(Yes) | 1 |
回答者B | 認知していない(No) | 0 |
回答者C | 認知している(Yes) | 1 |
回答者D | 認知している(Yes) | 1 |
回答者E | 認知していない(No) | 0 |
合計 / 平均 | Yesの割合:60% | 平均値:0.6 |
表のとおり、Yes/Noを1/0に変換して平均値を計算すると、認知率(60%)と平均値(0.6)は完全に一致します。
つまり、割合を扱っている場面であっても、それは「0と1に要約されたデータの平均値」を見ていることと同義です。したがって、平均値が持つ「回答数の少なさによる不安定さ」や「構成比の偏りによる影響」といった性質や限界は、割合のデータを解釈する際にもそのまま適用されます。
3. 実践ステップ ― 平均値を正しく読むための確認手順
ここまで見たように、平均値は分布を1点に要約する便利さと引き換えに、ばらつき・外れ値・回答数の影響といった情報を見えにくくします。
アンケート結果を正しく解釈するためには、平均値の数字を出した時点で結論を出さず、回答数・分布・外れ値・差の意味を順に確認していく作業が必要です。
単純集計の結果を手元に置いた段階から、判断に進むまでに踏むべき5つのステップを示します。
3-1. STEP1. 平均値で全体傾向を掴む
最初に、設問ごとの平均値を算出し、調査対象の大まかな傾向をつかみます。顧客満足度であれば5点満点中の位置、購入意向であればスコアの絶対水準、施策前後の比較であればビフォーアフターの差分など、設問の目的に応じた数値を確認します。
このSTEPで得る平均値は、あくまで全体像を把握するための最初のステップとして位置づけます。仮説の方向感を確かめたり、深掘りすべきセグメントを絞り込んだりする目的に使い、最終的な結論はSTEP2以降の確認を経てから判断します。
3-2. STEP2. 回答数とサンプル構成を確認する
平均値の数字を解釈する前に、計算の元となる回答数(n)と、回答者の属性構成を確認します。
3-2-1. 全体およびセグメント別の回答数を見る
全体のnと、クロス集計で比較したい各セグメントのnをそれぞれ確認する
一般的に、n=30程度を下回るセグメントでは平均値のブレが大きくなり、統計的な検定でも差が検出されにくくなる
回答数が少ないセグメントの平均値は、参考値として扱うか、自由記述などの定性情報と併せて解釈する
3-2-2. 回答者構成をターゲット層と比較する
性別・年代・会員ランクなど、想定する顧客構成と回答者構成を見比べる
大きな乖離がある場合は、平均値が特定の属性に引っ張られている可能性を疑う
確認項目 | チェック内容 |
全体の回答数 | 全体・セグメント別でn=30を下回るものがないか |
構成比 | 性別・年代などが想定する顧客層から大きく外れていないか |
欠損 | 設問ごとの有効回答数が著しく減っていないか |
3-3. STEP3. 回答分布を確認する
平均値が同じでも分布は異なります。STEP3では選択肢ごとの回答割合と、トップボックス率・ボトムボックス率を確認します。
確認する代表的な指標
トップボックス率:5点満点で最上位(5点)を選んだ人の割合
トップ2ボックス率:4点+5点を選んだ人の割合(肯定的評価の合計)
ボトム2ボックス率:1点+2点を選んだ人の割合(否定的評価の合計)
たとえば顧客満足度の調査で、平均値がいずれも3.0だった場合でも、回答分布によって示唆はまったく違ってきます。
回答パターン | 平均 | トップ2ボックス率 | ボトム2ボックス率 |
A:全員が中央(3点に集中) | 3.0 | 0% | 0% |
B:山型(中央寄りに分布) | 3.0 | 30% | 30% |
C:二極化 | 3.0 | 50% | 50% |
Cのように肯定派と否定派が拮抗しているケースでは、両者それぞれに対する打ち手を別個に用意する必要が出てきます。
一方、Aのように回答が中央に集中している場合は、まず認知や関与を高める方向の施策が優先候補になります。
なお、選択肢ごとの分布はダッシュボード上でグラフとして可視化しておくと、確認の手間が大きく省けます。
3-4. STEP4. 外れ値・欠損値を確認する
金額・利用回数・閲覧時間といった数値回答では、外れ値の混入によって平均値が大きく動きます。STEP3で分布を見る際に、極端な値が含まれていないかを併せて確認します。
3-4-1. 外れ値の確認
最大値・最小値、ヒストグラム、箱ひげ図などを用いて、分布の両端を確認する
外れ値が見つかった場合、入力ミスなのか特殊な少数例なのかを判別する
外れ値を残したまま判断する場合は、算術平均だけでなく中央値・トリム平均も併せて確認する
項目 | A | B | C | D | E | 算術平均 | 中央値 | トリム平均(上下20%除外) |
月間利用回数 | 2 | 3 | 4 | 5 | 50 | 12.8 | 4 | 4.0 |
この例では、算術平均(12.8)は外れ値1件に大きく引きずられています。中央値(4)やトリム平均(4.0)を併用することで、典型的な利用者像に近い数値を把握できます。
3-4-2. 欠損値の確認
設問ごとの有効回答数を確認し、無回答がどの程度含まれているかを把握する
集計時に無回答をどう処理するか(除外か代入か)を確認し、選択肢によって平均値が変動する余地があることを認識しておく
3-5. STEP5. 差を「効果」と早合点しない
施策の前後比較や、セグメント間比較で平均値に差が出た場合、その差を即座に「効果」「優位」と結論づけないようにします。
比較対象のそれぞれについて、STEP2(回答数)、STEP3(分布)、STEP4(外れ値)を確認したうえで差分を見る
差の絶対値が小さい場合や、回答数の少ないセグメント同士の比較では、誤差の範囲を超えていない可能性がある
その差が偶然による誤差の範囲かどうかは、統計的な検定で確認できる
「平均が0.2上がった」という結果が、施策の効果なのか、たまたまその回に上振れの回答者が集まっただけなのかは、平均値の数字だけでは判別できません。STEP1〜4で前提条件をそろえたうえで、必要に応じて検定や信頼区間の確認に進む、という順序で扱います。
4. 事例・サンプル:平均値の差を施策効果と読む前に確認すべきこと
ここでは、ここまで見てきた平均値の性質と確認手順を、典型的なマーケティング場面に当てはめてみます。
題材は、ECサイトのリニューアル前後で同じ5段階の顧客満足度調査を実施し、平均値の差から施策効果を判定するケースです。
4-1. 一次集計:平均値は0.2ポイント上昇
ECサイトの全面リニューアルから3カ月後、改修前後で同じ顧客満足度調査(5段階評価)を実施したとします。集計結果は次のとおりです。
調査時点 | 回答数(n) | 平均満足度 |
リニューアル前 | 400 | 3.5 |
リニューアル後 | 420 | 3.7 |
平均値は3.5から3.7へ、0.2ポイント上昇しています。回答数も同程度の規模で揃っており、数字だけを見れば「リニューアル成功」と結論したくなる結果です。
ただし、この調査はリニューアルと同時期に新規顧客獲得のための大規模なプロモーションを実施しており、調査期間中に新規登録ユーザーの流入が通常時より大きく増加していたという背景がありました。
回答者の顔ぶれが前回と同じとは限らないため、平均値の差をそのまま施策効果と判断する前に、次の2点を確認します。
回答者の属性構成が前後でどう変化したか
構成変化の影響を取り除いたとき、平均値の差はどの程度残るか
4-2. 確認①:回答者構成の前後比較
最初に、回答者の利用歴別の構成比を出して、前後の変化を確認します。
利用歴 | リニューアル前 | リニューアル後 |
新規(登録3カ月以内) | 22% | 41% |
既存(登録3カ月超) | 78% | 59% |
新規顧客獲得プロモーションの影響により、リニューアル後の調査では新規ユーザーの比率が約2倍に増えていました。
回答者の構成そのものが大きく変わっているため、平均値の差がリニューアルそのものの効果を測れているのか、構成変化を反映しているだけなのかは、この時点では判別できません。
4-3. 確認②:利用歴別に切り分けた平均値
そこで、利用歴ごとに平均値を再計算します。
利用歴 | リニューアル前 平均 | リニューアル後 平均 | 差分 |
新規(登録3カ月以内) | 4.0 | 4.1 | +0.1 |
既存(登録3カ月超) | 3.4 | 3.45 | +0.05 |
全体 | 3.5 | 3.7 | +0.2 |
層別に切り分けると、新規・既存どちらの層でも改善幅は小さい水準にとどまっています。それにもかかわらず全体平均が0.2ポイント上昇したのは、評価が高めに出やすい新規層の比率が増えたためです。
つまり、全体平均で見ると改善があるように見える一方、層別に見るとどちらもほぼ動いていない、という相反するシグナルが同時に出ている状態です。
4-4. 解釈と意思決定への接続
確認の結果を整理すると、次のように読めます。
全体平均の差(約+0.2)は、リニューアルによる評価改善というより、回答者構成の変化を大きく反映している可能性が高い
既存ユーザーに絞ると、リニューアル後の評価はほぼ変わっていない
新規ユーザーは元から評価が高めに出る傾向があり、ここの厚みが全体平均を引き上げている
ここから引けるアクションは、「リニューアル成功」という単線的な結論ではなく、評価指標の分解です。
リニューアルのサービス改善効果を測りたいなら、既存ユーザーの動きを切り出して判定する
新規顧客獲得プロモーションの集客効果は、別の指標(新規登録数、CVR、初回購入額など)で評価する
新規ユーザーの満足度が既存ユーザーより高い状態が、登録直後の評価上振れによるものか、リニューアル後のUXが新規利用者に特に好適だったかは、追跡調査での見極めが必要
平均値の差は単一の数字として表れますが、その内側には「誰が、どんな比率で、どう評価したか」という構造があります。
差の絶対値だけを見て施策効果と即断せず、回答者構成と層別の動きまで分解して読むことが、施策の意思決定を誤らせないための前提になります。
5. よくある失敗と対策
特によくある4つの失敗例を取り上げ、それぞれの原因と具体的な対策を解説します。
5-1. 平均値だけで「問題ない」と判断する
顧客満足度調査や製品評価において、平均値のスコアが目標値に達していることだけを確認し、施策を終了してしまうケースです。
なぜ起こるか
新規サービスの利用満足度調査(5点満点)を実施したところ、全体平均が3.8であったため、「ユーザーはおおむね満足しており、大きな問題はない」と判断して改善施策を見送るような場面です。
平均値は、分布の情報を1点に要約して表現する指標です。平均値が3.8であっても、回答者全員が4点前後に集中しているとは限りません。
大満足している5点の層と、強い不満を持つ1点や2点の層に二極化している可能性を見落としてしまうことが原因です。不満層が一定数存在するリスクに気づけず、顧客離脱の兆候を捉えられなくなります。
対策
平均値を見る際は、必ず選択肢ごとの回答分布(%)をセットで確認します。特に「1点+2点」の合計であるボトム2ボックス率に着目し、全体の平均スコアが高くても、否定的な評価を与えているユーザーが一定割合以上存在しないかをチェックします。
5-2. 回答数が少ないグループの平均値を大きく扱う
クロス集計を行う際、特定の属性グループの回答数が極めて少ないにもかかわらず、その平均値の高低を根拠にターゲットを選定してしまうケースです。
なぜ起こるか
認知度調査において、年代別のクロス集計を行ったところ、20代女性の認知率(割合の平均値)が80%と他の年代より突出して高かったため、20代女性を最優先ターゲットに設定して広告予算を投入するような場面です。
集計対象となる回答数(サンプルサイズ)が少ないグループの平均値は、偶然の要素に左右されやすく、データの安定性を欠きます。
例えば、20代女性の回答者数がわずか5名しかいなかった場合、4名が「認知している」と答えるだけで割合は80%になります。
これは集団全体の真の傾向を反映しているとは言えず、認知率が過大に評価されているリスクを見落とすことが原因です。
対策
平均値を比較する前に、各グループの有効回答数(n)を必ず確認します。
統計的な観点から、グループの回答数がn=30を下回る場合は、その平均値を意思決定の絶対的な根拠にせず参考値として扱います。
5-3. 外れ値を含んだまま金額の平均値を見る
購入金額や利用頻度といった、上限のない数値回答の集計において、算術平均の値だけを市場規模や顧客単価の基準にしてしまうケースです。
なぜ起こるか
1回あたりの購入金額に関する調査で、全体の算術平均が「8,500円」だったため、平均的な顧客像を「約8,000円を消費する層」と定義し、次のキャンペーンの割引条件を「8,000円以上購入で適用」に設定するような場面です。
算術平均は、すべての回答データの合計値を分母で割るため、極端に大きな値(外れ値)に引きずられる性質を持ちます。
ごく一部のヘビーユーザーが「10万円」といった突出した金額を回答していた場合、大半の一般的なユーザーの購入額が2,000円前後であったとしても、全体の平均値は押し上げられます。この平均値を基準にすると、実態とかけ離れた施策を立案することになります。
対策
金額や回数などの数値を扱う設問では、算術平均だけでなく、データを順に並べた中央の値である「中央値」や、上下の極端な値を除外して計算する「トリム平均」を併せて算出します。
以下の表は、外れ値が算術平均に与える影響と、代替指標による見え方の違いを示す一例です。
回答者の内訳 | Aさん | Bさん | Cさん | Dさん | Eさん | 算術平均 | 中央値 | トリム平均(上下20%除外) |
1人だけ突出した高額回答 | 1,500円 | 2,000円 | 1,800円 | 2,200円 | 35,000円 | 8,500円 | 2,000円 | 2,000円 |
表からわかるように、大半のユーザー(A〜Dさん)は2,000円前後の購入ですが、Eさんの35,000円という外れ値によって算術平均は8,500円まで跳ね上がります。この場合、中央値やトリム平均の「2,000円」のほうが、典型的な顧客の実態を正しく捉えていると判断できます。
5-4. 平均値の差をそのまま施策効果と考える
プロモーションやWebサイトの改修前後で平均値に上昇が見られた際、その差の背景にある回答者構成の変化を無視して、施策が成功したと結論づけるケースです。
なぜ起こるか
自社製品のユーザーを対象に「総合満足度(5点満点)」の定点調査を毎年実施しており、今年の全体平均が前年の「3.4」から「3.7」へ0.3ポイント上昇したため、「この1年間の品質改善施策には明らかな効果があった」と評価するような場面です。
平均値の数字は、データを誰から回収したかに強く依存します。例えば、前年よりも購入頻度の高い「ヘビーユーザー」からの回答割合が大きく増えていた場合、製品自体の評価が変わっていなくても、好意的な回答が集まりやすくなるため全体平均は押し上げられます。
属性構成の偏りを検証せずに、平均値の差分をすべて施策の効果(品質改善の成果)と捉えるのは、誤った因果関係の解釈につながります。
対策
前後の比較で平均値に差が生じた場合は、まず調査対象者の属性構成(性別、年代、利用歴など)に変化がないかを確認します。
構成に偏りがある場合は、属性ごとにデータを細分化してクロス集計を行い、それぞれの層において本当に対象の施策によるスコアの上昇が見られるかを切り分けて検証する流れとなります。
また、その差が偶然の誤差の範囲内か、意味のある差なのかを客観的に見極めるアプローチを意識することが大切です。
6.平均値の読み解き方に関するFAQ
Q: 満足度調査などで平均値が目標をクリアしていても、それだけで安心できないのはなぜですか?
A: 平均値はデータを1つの数値に丸めてしまうため、その背後にある回答のばらつきが見えなくなるからです。たとえば「大満足」と「大不満」に意見が真っ二つに分かれている二極化のケースでも、平均すると中間のスコアになってしまいます。必ず選択肢ごとの回答分布や、不満層の割合(ボトムボックス率)をセットで確認することが大切です。
Q: 購入金額や利用回数の平均値を見る際、一部のヘビーユーザーの影響を排除するにはどうすればよいですか?
A: 極端に大きな数値(外れ値)に引きずられやすい算術平均だけでなく、「中央値」や「トリム平均」を併用します。データを順番に並べた真ん中の値である中央値や、上下の極端な回答を一定割合除外して計算するトリム平均を確認することで、一般的なユーザーの実態に近い数値を把握できるようになります。
Q: 施策の前後で全体平均のスコアが上がった場合、それをそのまま施策の効果と判断してはいけないのですか?
A: スコアの上昇が、施策そのものの効果ではなく「回答者の属性構成の変化」によってもたらされている可能性があるためです。たとえば、元から評価を高めに付けやすい「新規ユーザー」の比率がプロモーション等で一時的に増えた場合、個々の満足度が変化していなくても全体平均は押し上げられます。比較を行う際は、まず前後の属性構成に偏りがないかを確認し、必要に応じて属性ごとにデータを細分化(クロス集計)して検証する必要があります。
7. まとめ
アンケートの集計業務において、平均値は大量の回答データを1つの数値にまとめて示してくれる、非常に便利で扱いやすい指標です。
本記事で解説してきたように、平均値は分布の情報を1点に要約する過程で、多くの重要な情報を削ぎ落としています。平均値は分析の結論ではなく、データの背後にある実態を探るための手がかりにすぎません。
アンケート結果から顧客の真の姿を捉え、的確なマーケティング施策につなげるためには、平均値を確認した後に必ず以下のポイントをセットでチェックしましょう。
回答の分布(ばらつき):特定の選択肢に集中しているか、あるいは二極化しているか
有効回答数(n数):比較対象のグループに十分なサンプルサイズが確保されているか
外れ値の有無:極端な数値に平均値が引きずられていないか(必要に応じて中央値やトリム平均を併用する)
回答者の属性構成:前後の比較において、回答者の構成比(ヘビーユーザーの割合など)に偏りが生じていないか
データが持つ本当の意味を見極めるためには、数字の表面的な高低に惑わされず、その背景にある「データの構造」まで丁寧に読み解く姿勢が求められます。
集計業務の効率化や、リアルタイムでの回答分布の可視化には、単純集計結果を自動でグラフ化できるセルフ型アンケートツールの活用も有効です。正しいデータの読み方を身につけ、日々のアンケート業務をより精度の高い意思決定の基盤として役立ててください。