 お問い合わせ
アンケートデータを活用してビジネスの次の一手を打つためには、データを特定の条件で切り分けてグループ間の違いを比較するクロス集計が欠かせません。
本記事では、クロス集計の表示形式やベース(分母)の正しい捉え方といった基礎知識から、データの信頼性を担保するサンプルサイズ(n数)の基準、レポート作成時に陥りやすい失敗と対策までを解説します。
1. 導入:単純集計だけでは見えない「回答者ごとの差」
アンケートの集計作業で最初に行う単純集計によって、全体の何割がその選択肢を選んだかという大まかな傾向を掴むことができます。
たとえば、あるサービスの購入意向を調査し、単純集計で「利用したい」人が40%という結果が出たとします。
この40%という数字をそのまま受け取ると、全体の半分に満たない、限定的なニーズにとどまるという解釈だけで終わってしまいます。
単純集計とクロス集計の見え方
年代別のクロス集計表(横%表)に展開してみると、回答者の年齢層によって大きな開きがあることが見えてきます。
全体では「利用したい」と回答したのは40%ですが、20代に絞ると60%と過半数を超えているのに対し、50代では20%と、年代によって大きな差があることがわかります。
全体平均に埋もれてしまいがちな、誰が、どのように答えているかを構造的に浮かび上がらせることで、ターゲット層の特定や具体的な施策の検討といった、次の一手へ繋がる重要な示唆を得ることができます。
本記事では、クロス集計の作り方と見方を正しく理解し、実際の意思決定に活かせるようになることを目指します。
2. 基礎知識:クロス集計の用語と見方
クロス集計表はクロス表や分割表とも呼ばれ、基本的には2つの質問項目を横(行)と縦(列)に掛け合わせて作成します。
2-1. クロス集計とは
単純集計が回答者全員を1つの分母として、全体の傾向を見る集計表だとすれば、クロス集計は特定の条件でデータを切り分けて、そのグループ間での違いを比較するための集計表です。
掛け合わせる2つの項目には、それぞれ以下の役割があります。
条件となる項目(表頭または表側に来る「軸」となる項目)
例:性別、年代、居住地域、会員ランクなど
説明変数(独立変数)と呼ばれます
回答の分布を見る項目
例:満足度、購入意向、利用頻度、ブランドの認知有無など
目的変数(従属変数)と呼ばれます
どのような条件(切り口)によって、回答の分布にどのような違いや傾向が生まれているかを確かめることが、クロス集計を行う目的です。
2-2. クロス集計表で使う基本用語
クロス集計表のデータを正しく読み解くための基礎となる、表の構造に関する用語です。
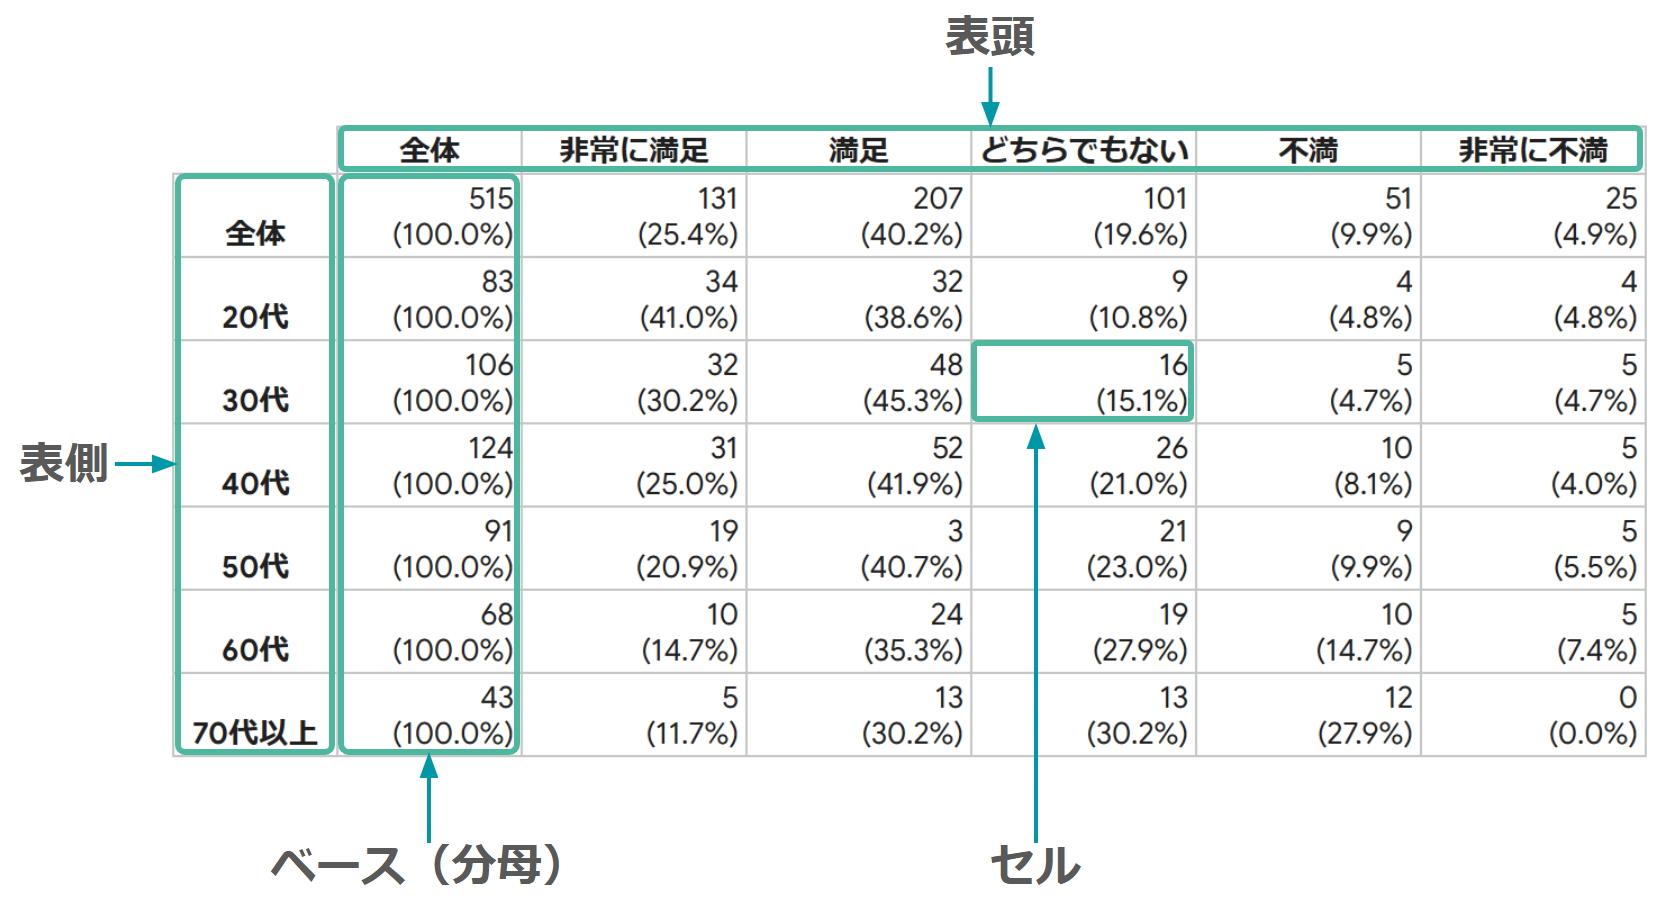
表側(ひょうそく)と表頭(ひょうとう)
表の行の見出しを「表側」、列の見出しを「表頭」と呼びます。
表側と表頭にそれぞれ異なる分析の軸(項目)を割り当てて格子状に掛け合わせます。表側に性別や年代などの属性、表頭に質問に対する回答項目を配置するのが一般的な形ですが、分析の目的に応じて「質問項目×質問項目」のように軸を組み替えて構成することもあります。
ベース(分母)
割合(%)を計算する際の基準となる数値(総数)のことです。
表側(属性)と表頭(回答)のどちらの数値を基準(100%)にして割合を計算するかによって、データの意味合いが大きく変わります。
セル
縦の列と横の行が交差する、一つひとつのマス目のことです。
このセルの中に、掛け合わせた条件に該当するデータが格納されます。
2-3. クロス集計表の表示形式
クロス集計表は、表側と表頭の配置が決まれば、そこからデータを比較したい方向に応じて分母をどこに取るか(%の計算方向)が必然的に定まります。
表側・表頭の項目の交点となるセルの中に、具体的にどのような数字を映し出すかという表示形式を選択します。
回答数(度数)を見せるのか、割合(%)を見せるのか、あるいはその両方を載せるのかは、集計ソフトやExcelなどのツールを使って必要に応じて選択します。
この分母の取り方とセルに表示する内容の組み合わせによって、クロス集計表には以下の5つの形式があります。
1. n表(実数表)
満足度(表頭) \属性(表側) | 満足 | どちらとも | いえない | 不満 | 合計 |
男性 | 63 | 51 | 28 | 142 | |
女性 | 85 | 49 | 24 | 158 | |
全体 | 148 | 100 | 52 | 300 |
回答者の「実数(人数や件数)」だけを記載した、すべての基本となる表です。データの規模感(全体で何人いるのか)を正確に把握する際に使用します。「n」はサンプルサイズ(総数)を意味します。
2. 全体 %(ベース%)表
満足度(表頭) \属性(表側) | 満足 | どちらとも | いえない | 不満 | 合計 | (構成比) |
男性 | 21.0% | 17.0% | 9.3% | 47.3% | ||
女性 | 28.3% | 16.3% | 8.0% | 52.7% | ||
全体 | 49.3% | 33.3% | 17.3% | 100.0% |
すべてのセルの数値を、全体の総数(この場合は300)を100%とした場合の割合に変換した表です。全体の中で、どの組み合わせの割合が最も高いかを俯瞰する際に役立ちます。
3. n%表(度数・割合併記表)
満足度(表頭) \属性(表側) | 満足 | どちらとも | いえない | 不満 | 合計 | |||
男性 | 63 | (21.0%) | 51 | (17.0%) | 28 | (9.3%) | 142 | (47.3%) |
女性 | 85 | (28.3%) | 49 | (16.3%) | 24 | (8.0%) | 158 | (52.7%) |
全体 | 148 | (49.3%) | 100 | (33.3%) | 52 | (17.3%) | 300 | (100.0%) |
度数(n)と割合(%)を一つのマスに同時に記載した表です。実際のボリューム感と割合の傾向を一度に確認できるため、実務の報告書などで最もよく使われる形式です。
4. 横(行)%表
満足度(表頭) \属性(表側) | 満足 | どちらとも | いえない | 不満 | 合計 |
男性 | 44.4% | 35.9% | 19.7% | 100.0% | (142) |
女性 | 53.8% | 31.0% | 15.2% | 100.0% | (158) |
全体 | 49.3% | 33.3% | 17.3% | 100.0% | (300) |
横方向(行)の合計を100%として計算した表です。「20代のうち、満足している人は何%か」というように、表側の属性ごとの傾向や違いを比較したいときに使用します。
5. 縦(列)%表
満足度(表頭) \属性(表側) | 男性 | 女性 | 全体 | |||
満足 | 44.4% | 53.8% | 49.3% | |||
どちらとも | いえない | 35.9% | 31.0% | 33.3% | ||
不満 | 19.7% | 15.2% | 17.3% | |||
合計 | 100.0% | (142) | 100.0% | (158) | 100.0% | (300) |
縦方向(列)の合計を100%としたもので、横(行)%表の表側・表頭を入れ替えた形です。
表側と表頭にどの項目を取るか、また、行と列のどちらの合計を分母nとするかについて、絶対的なルールがあるわけではないため、縦%で作成するケースもあります。
一般的に、国内では横%で表示する慣例があり、海外では縦%が使われている例が多く見られます。
2-4. 信頼性を担保するサンプルサイズ(n数)の基準
クロス集計を行う際、集計結果の信頼性を大きく左右するのがサンプルサイズ(n数)です。データを細かく分割すればするほど、1つひとつのセルに含まれる回答者の数は少なくなります。
2-4-1. ① 最低限必要なセルの度数の目安(n≧30)
クロス集計表の各セルを読み取る際、「セルの実数が30未満」の場合は、統計的な信頼性が低い参考値として扱うのが基本です。
サンプルサイズが大きくなるほど標本平均が正規分布に近づくという中心極限定理にもとづき、サンプルサイズが30以上あれば、母集団の元の分布に関わらず、標本平均の分布を正規分布とみなして良い、という経験則が広く使われています。
最も誤差が大きく出るケース(割合p=50%)を例に、n数による精度の違いを比較すると以下のようになります。
n数 | 標準誤差 | 95%信頼区間(±1.96×標準誤差) | データの状態と判断 |
10 | 15.8% | ±31.0% | 誤差の幅が62%にも及び、実用にならない |
30 | 9.1% | ±17.9% | 誤差が±18%以内に収まり、「だいたい〇割」という実務判断がギリギリ可能 |
100 | 5.0% | ±9.8% | 誤差が±10%を切り、より安定した分析が可能 |
2-4-2. ② 実務におけるデータ加工の工夫(グルーピング)
集計の段階で特定のセルの度数(実数)が30未満になり、信頼性が担保できないと判断された場合は、選択肢や属性区分を統合(グルーピング)して1セルあたりの分母を増やし、標準誤差を抑える方法があります。
たとえば、5段階評価の選択肢(非常に満足/満足/どちらでもない/不満/非常に不満)を「満足層(非常に満足+満足)」「中立(どちらでもない)」「不満層(不満+非常に不満)」の3区分に統合すれば、各層の分母が大きくなり、より安定した比較が可能になります。
3. 実践:クロス集計を進める7つのステップ
ここでは、架空のカフェチェーン「Cafe X」の利用実態調査(回答者数:n=500)を例に、クロス集計の具体的な手順を7つのステップで解説します。
ダミー調査の前提条件
調査名:Cafe Xの利用実態調査
回答者数:n=500
主な設問項目:
Q1. 性別:男性/女性(単一回答:SA)
Q2. 年代:20代/30代/40代/50代以上(単一回答:SA)
Q3. 全体満足度:非常に満足/満足/どちらでもない/不満/非常に不満(5段階単一回答)
3-1. ステップ1:調査設計段階でクロス集計を想定する
質の高い集計結果を得るためには、データを集める前の調査設計が重要です。 今回の調査目的である「Cafe Xの利用層と満足度の構造を把握したい」というゴールを達成するために、事前に以下のような仮説を立てたとします。
「若年層ほど満足度が高く、高年齢層ほど満足度が低いのではないか」
「性別によって利用頻度に差があるのではないか」
この仮説を検証するために、性別や年代を重要な分析軸として位置づけ、満足度や利用頻度の選択肢も、グループ間の違いが明確に浮かび上がるように設定します。
重要なのがサンプルサイズ(n数)の確保です。今回の調査では、性別×年代(8セグメント)での掛け合わせを想定し、全体で500のサンプルサイズを確保する設計としました。
仮に、性別×年代に「満足度の5段階評価」までを掛け合わせたすべてのセル(計40マス)で一律に30名以上を確保しようとすると、最低でも1,200名のサンプルが必要になります。
この例では、主要な分析軸である8セグメントにおいて各セルn≧50〜60名を確実に担保し、回答の分散によるブレを最小限に抑える実務的な妥協ラインとして、500名前後を目安としています。
3-2. ステップ2:単純集計(GT集計)で全体像を把握する
データが回収できたら、集計の第一歩として各設問の度数と割合を確認する単純集計を行います。全体のボリューム感や大まかな傾向をここでつかみます。
【Q2. 年代(単純集計)】
年代 | 度数(人) | 割合 |
20代 | 150 | 30.0% |
30代 | 130 | 26.0% |
40代 | 120 | 24.0% |
50代以上 | 100 | 20.0% |
合計 | 500 | 100.0% |
【Q3. 全体満足度(単純集計)】
選択肢 | 度数(人) | 割合 |
非常に満足 | 80 | 16.0% |
満足 | 180 | 36.0% |
どちらでもない | 150 | 30.0% |
不満 | 60 | 12.0% |
非常に不満 | 30 | 6.0% |
合計 | 500 | 100.0% |
単純集計の段階でわかるのは「満足」以上の合計が52.0%、「不満」以下の合計が18.0%という、あくまで全体の平均値だけです。
これだけでは「どの層が満足していて、どの層が不満を抱いているのか」という詳細な内訳は判別できません。このような全体の傾向から一歩進め、属性ごとの違いを明らかにするのがクロス集計です。
3-3. ステップ3:分析軸(表側)と比較項目(表頭)を決定する
調査目的である「年代によって満足度に差があるか」を検証するため、表の骨組みを決めます。
表側(説明変数・分析軸):年代(20代/30代/40代/50代以上)
表頭(目的変数・比較項目):満足度(5段階)
クロス集計表を作る際の原則として、要因・原因となる項目(説明変数)を表側に置き、結果となる項目(目的変数)を表頭に配置すると、後述する「行%」の見方が非常にスムーズになります。
今回は「年代(原因)が満足度(結果)に影響を与えるか」を見たいので、年代を表側に配置します。
3-4. ステップ4:n表(度数表/実数表)を作成する
配置が決まったら、各セルが交差する位置に実際の回答数を割り振ったn表(度数表/実数表)を作成します。
Excelで集計する場合は、ピボットテーブル機能でローデータからクロス集計表を作成します。アンケート専用の集計ソフトを使えば、設問と選択肢を指定して、より簡単にクロス集計表を出力することができます。
【年代 × 満足度(度数)】
年代 | 非常に | 満足 | 満足 | どちら | でもない | 不満 | 非常に | 不満 | 計 |
20代 | 35 | 65 | 35 | 10 | 5 | 150 | |||
30代 | 25 | 50 | 40 | 10 | 5 | 130 | |||
40代 | 15 | 40 | 40 | 15 | 10 | 120 | |||
50代以上 | 5 | 25 | 35 | 25 | 10 | 100 | |||
計 | 80 | 180 | 150 | 60 | 30 | 500 |
3-5. ステップ5:サンプルサイズ(n数)を確認する
クロス集計表のセルの実数が30以上あるかを確認します。このn表では以下の緑色の部分が30に満たない回答数です。
前述したように、各セルのn数が30を下回る部分については、回答誤差のブレが割合に変換した場合の差を上回る可能性があることを前提に数値を解釈する必要があります。
年代 | 非常に | 満足 | 満足 | どちら | でもない | 不満 | 非常に | 不満 | 計 |
20代 | 35 | 65 | 35 | 10 | 5 | 150 | |||
30代 | 25 | 50 | 40 | 10 | 5 | 130 | |||
40代 | 15 | 40 | 40 | 15 | 10 | 120 | |||
50代以上 | 5 | 25 | 35 | 25 | 10 | 100 | |||
計 | 80 | 180 | 150 | 60 | 30 | 500 |
この例では、年代ごとの回答分布に明確な傾向が現れている(若年層 → 満足、高齢層 → 不満足)と判断して、このまま分析を進めます。
3-6. ステップ6:割合を算出し、%の計算方向を選択する
実数のままでは、各年代の分母とする人数が異なるため割合(%)に変換します。
各年代の度数を分母(100%)として横方向に割合を計算した表です。割合に変換したことで年代ごとの構成比を比較できるようになります。
【年代 × 満足度(横%)】
年代 | n | 非常に | 満足 | 満足 | どちらでもない | 不満 | 非常に | 不満 | 計 |
全体 | 500 | 16.0% | 36.0% | 30.0% | 12.0% | 6.0% | 100.0% | ||
20代 | 150 | 23.3% | 43.3% | 23.3% | 6.7% | 3.3% | 100.0% | ||
30代 | 130 | 19.2% | 38.5% | 30.8% | 7.7% | 3.8% | 100.0% | ||
40代 | 120 | 12.5% | 33.3% | 33.3% | 12.5% | 8.3% | 100.0% | ||
50代以上 | 100 | 5.0% | 25.0% | 35.0% | 25.0% | 10.0% | 100.0% |
3-7. ステップ7:結果を読み取り、解釈する
最後に、計算した行%表の数値を観察し、ステップ1で立てた初期仮説と照らし合わせながら、次のアクションにつながる示唆を導き出します。
3-7-1. ① データの読み取り
満足層の傾向:「満足以上(非常に満足+満足)」の比率を横並びで比較すると、20代の66.6%から、30代57.7%、40代45.8%、50代以上30.0%へと、年代が上がるにつれて直線的に低下している。
不満層の傾向:逆に「不満以下(不満+非常に不満)」の比率は、20代10.0%から、30代11.5%、40代20.8%、50代以上35.0%へと、年代とともに上昇している。
特筆すべき点:特に50代以上のセグメントにおいては、満足層(30.0%)よりも不満層(35.0%)の割合が高くなる「逆転現象」が起きている。
3-7-2. ② 解釈とネクストアクション
データから、事前の仮説であった「若年層ほど満足度が高い」という傾向が裏付けられ、店舗運営における明確な課題として「高年齢層の離脱・不満リスク」が浮かび上がります。
この結果をもとに以下のような次の取るべきアクションが明確になります。
50代以上の不満理由を特定するため、同セグメントの「自由記述(定性コメント)」のテキストデータを抽出して分析する。
「不満」と回答した50代以上の35人(不満25人+非常に不満10人)を対象に、個別のインタビュー調査(定性調査)への移行を検討し、具体的な離脱原因(メニュー、接客、客席の居心地など)を深掘りする。
集計作業を仮説の検証に留めず、具体的な改善アクションや次の問いを立てるための起点として活かすことでデータの価値はさらに高まります。
4. 気になる結果をその場で深掘りできる「フィルター集計」機能
集計作業のなかで、単純集計で全体の傾向をつかんだ後、特定の回答に絞ったときの結果が見たいと感じる場面は少なくありません。
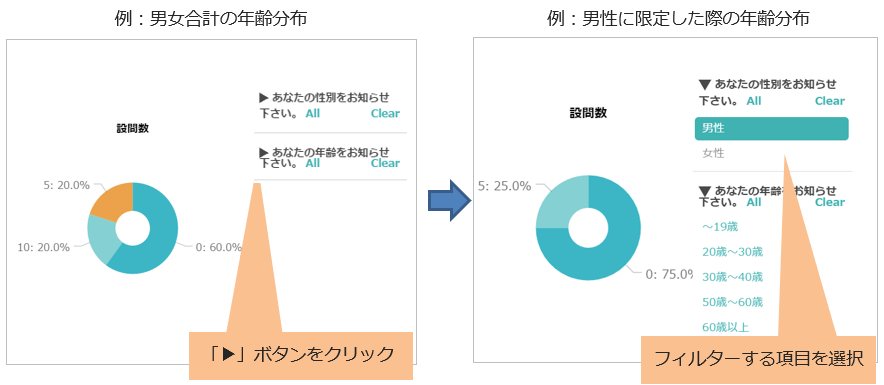
QiQUMOには、ダッシュボード上で特定の設問や選択肢を指定し、その条件に合致する対象者だけの集計結果(グラフ)を瞬時に切り出す「フィルター集計」機能が備わっています。
クロス集計の本質は、データの内訳を詳細に見ていくことにあります。この機能を活用すれば、複雑な集計画面に移行することなく、画面上でシームレスにデータの深掘りが可能です。
4-1. フィルター集計機能を使う場面
本機能は、特定の回答をした人に絞った時の全体の単純集計結果をダッシュボード上でクイックに確認したいときに真価を発揮します。
例えば、新商品の認知度調査において「購入意向を示した人」だけにフィルターをかけることで、その層が「どの媒体で商品を知ったのか」「どのようなベネフィットに魅力を感じているのか」など、別途クロス集計作業を行わなくても、ダッシュボード上で確認することができます。
活用時のポイント 本機能でフィルタリングできるのは、アンケートの設問として設定した項目に限られます。そのため、性別や年代、職業といった基本属性を切り口としてダッシュボード上でクイックに検証したい場合は、あらかじめアンケート内の設問(事前調査や本調査の質問項目)として組み込んでおく設計がおすすめです。
4-2. フィルター集計機能の使い方
ダッシュボード上での操作は非常にシンプルで、直感的に条件を指定できます。
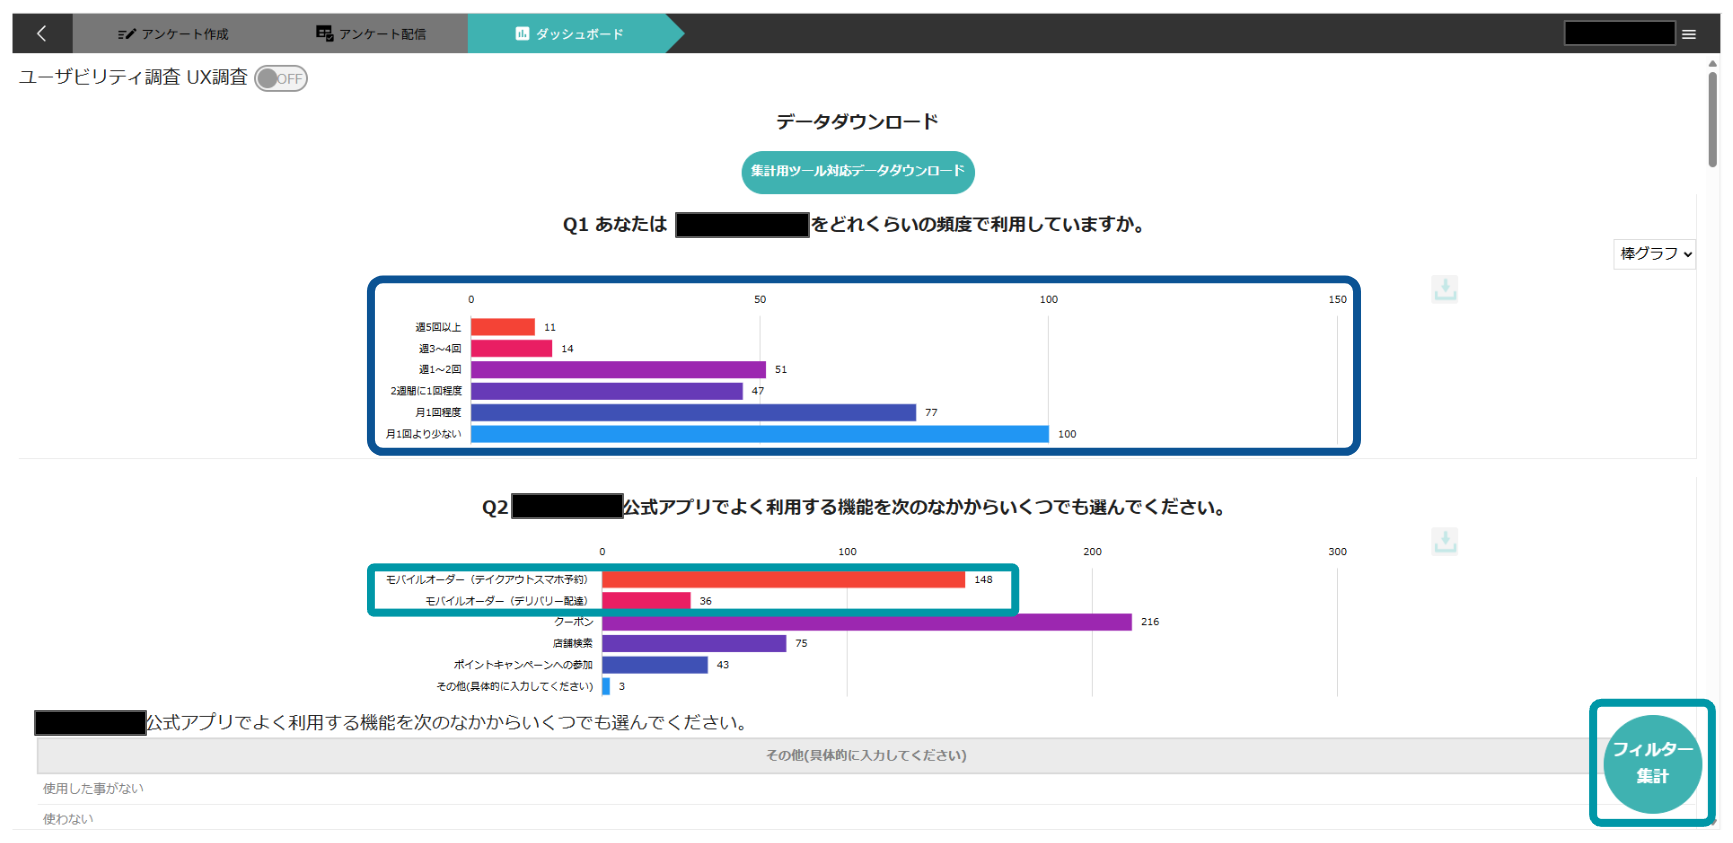
1: 対象設問の選択: ダッシュボードの画面右下に表示されている「フィルター集計」をクリックします。
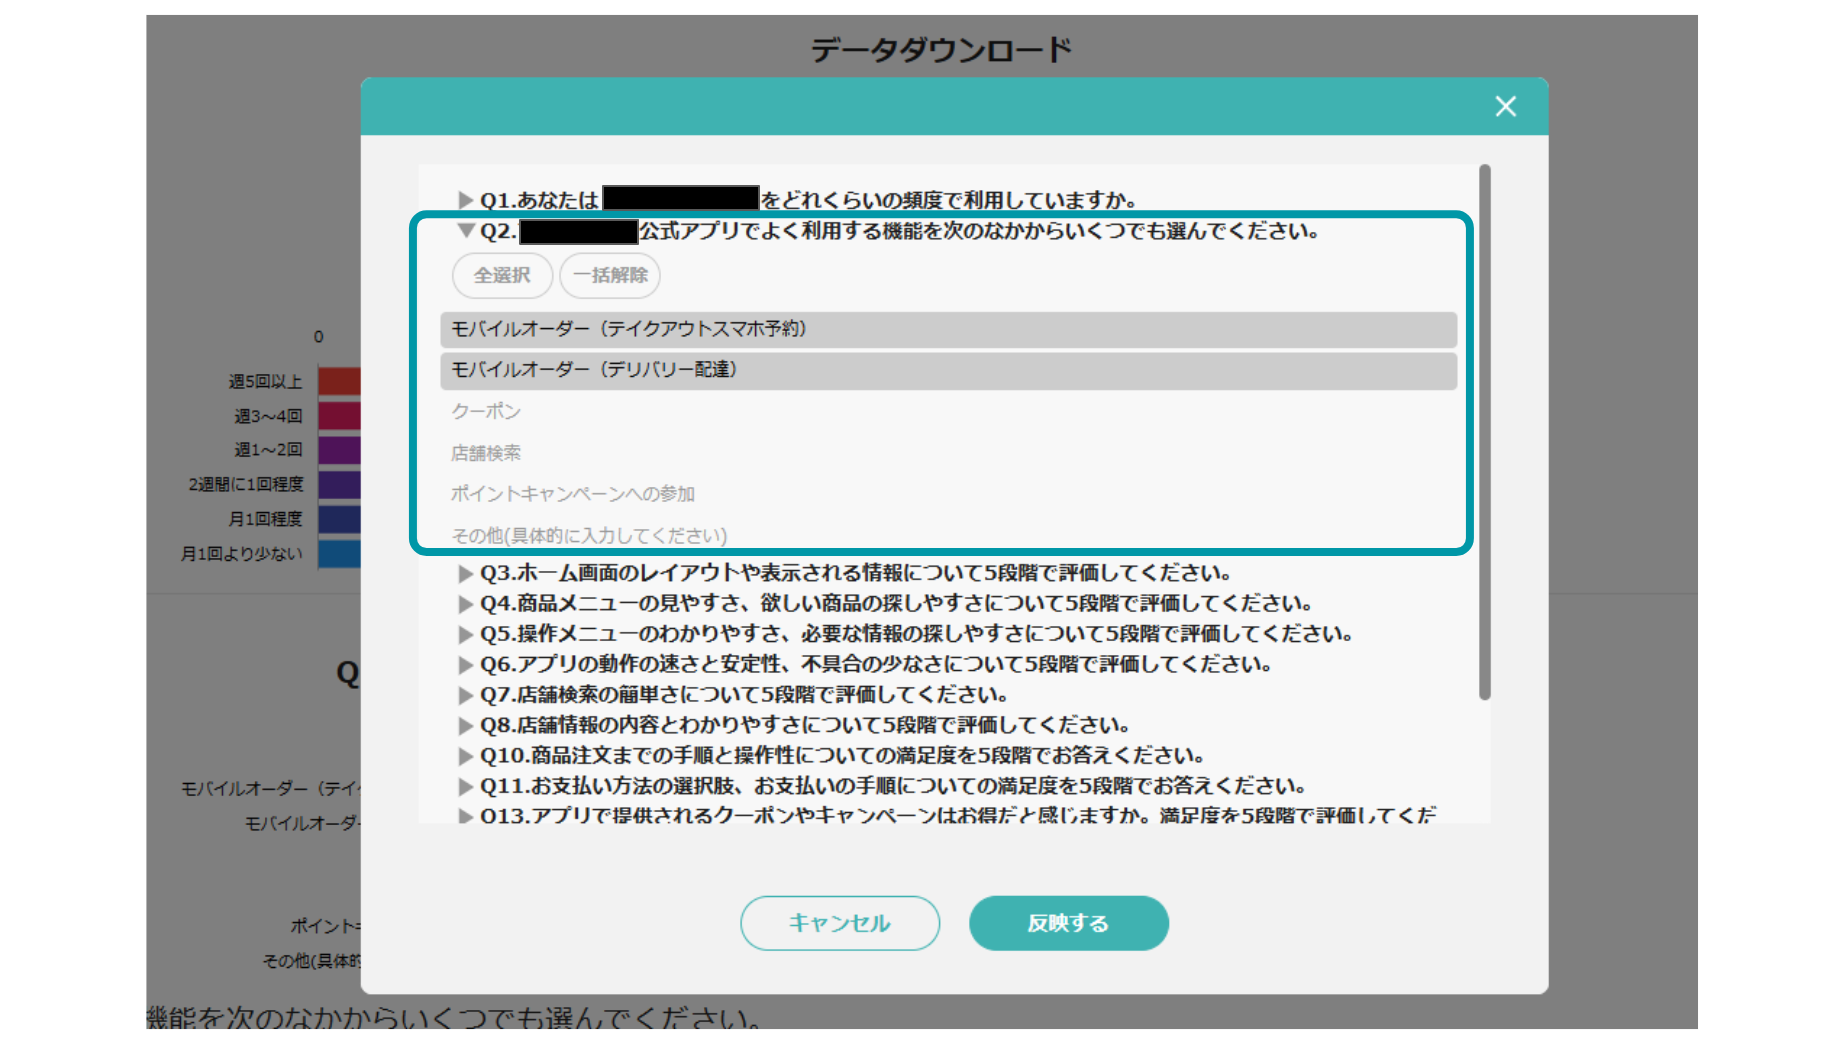
2: 条件(選択肢)の指定: 別ウィンドウで設問と選択肢が表示されるので、切り出したい設問と選択肢を指定します。
3: グラフの自動更新: 条件を適用すると、ダッシュボード全体の単純集計グラフが、指定した条件の回答者のみのデータに一斉に切り替わります。
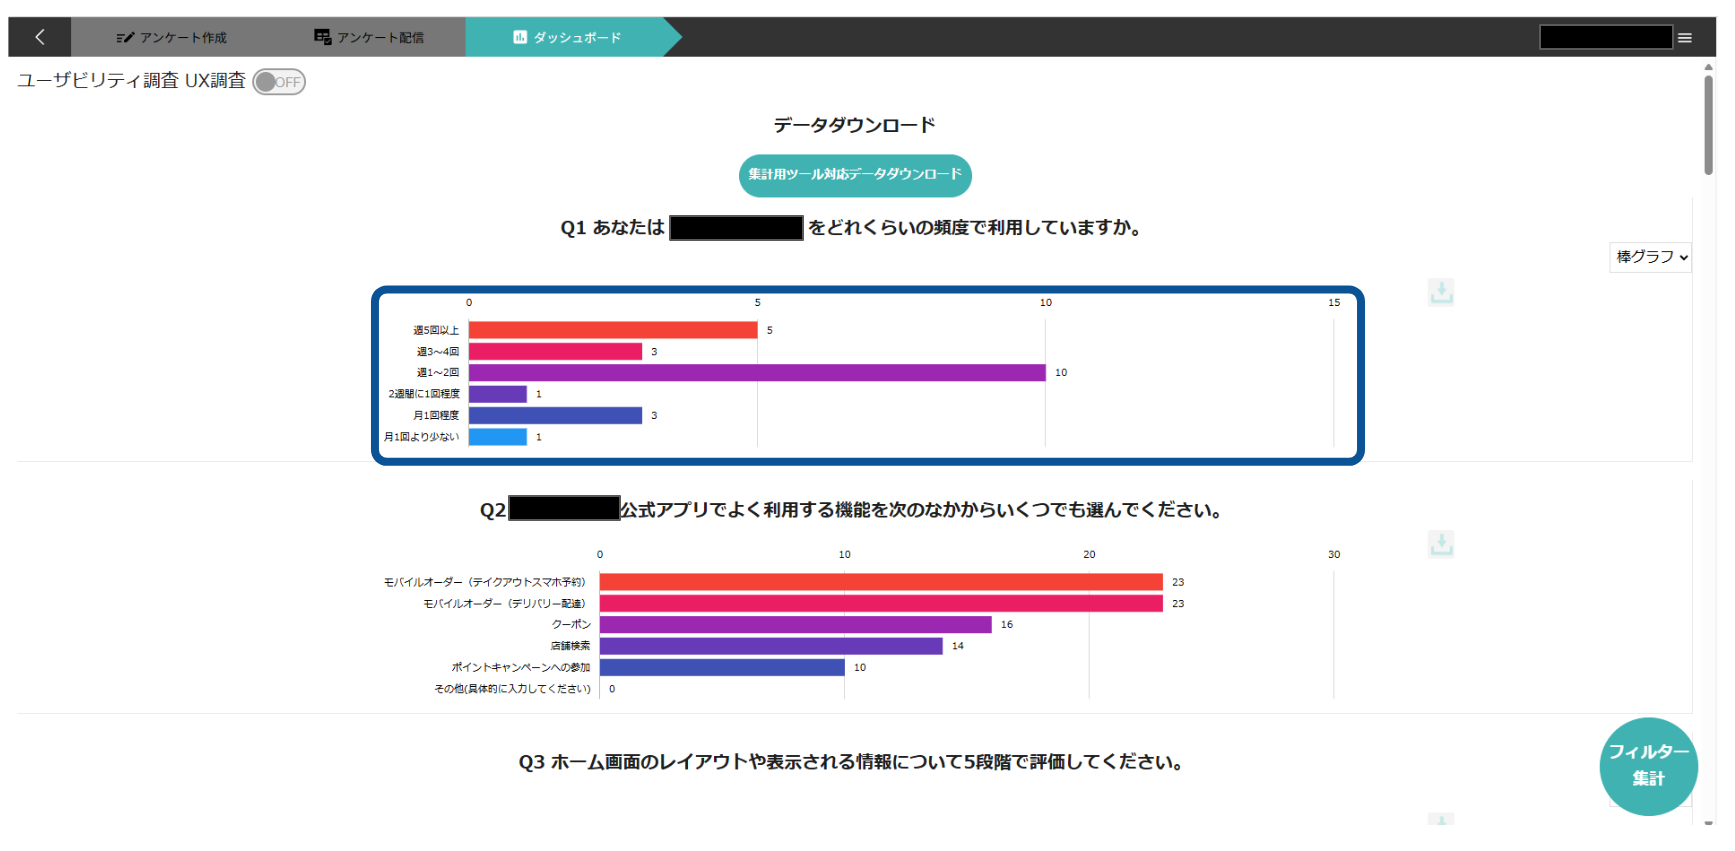
これにより、複雑なクロス集計のためのデータ加工の手間をかけずに、必要なデータだけを抽出した視覚的なレポートをその場で表示させることができます。
5. よくある失敗と対策
集計から読み解きへのプロセスで陥りやすい代表的な失敗を取り上げ、それぞれの原因と対策を整理します。
5-1. 軸を増やしすぎてセルのサンプルサイズが不足する
属性を細かく分けすぎると、各セルの実数値が30を下回り、見かけの差を実態と取り違える原因になります。
なぜ起こるか
属性を細かく分けるほど、各セルに含まれる回答者数は少なくなり、偶然のブレが大きな%差として表面に現れます。
本来は標本誤差の範囲内に収まる差を実態と取り違える差の過大評価と、1枚の表に分割数の多い情報が並ぶことで論点を読み取りにくくなる表の可読性低下という、2つの問題が発生します。
対策
セルあたりのn数を必ず確認し、n=30未満のセルは「参考値」として扱う
セルが薄い場合は、選択肢の集約(5段階→3段階)や属性区分の統合(10歳刻み→20歳刻み)でn数を確保する
1表につき1論点を原則とし、3重以上のクロスは特別な目的(例:特定セグメント内のさらなる深掘り)がある場合に限る
5-2. 相関を因果と決めつけてしまう
クロス集計で見える関連性と因果関係は別物であり、因果と決めつけて施策に落とすと判断を誤ります。
なぜ起こるか
たとえば、「20代の購入意向が高い」という結果を見て、「若年層向けに売れる商品だ」と安易に結論づけてしまうケースが挙げられます。
この場合、年代という属性そのものの裏側には、SNSの接触頻度や可処分所得、ライフスタイルといった「第三の要因」が潜んでいることが少なくないからです。
2軸のクロス集計が示すのはあくまで傾向(相関関係)であり、必ずしも因果関係を示しているわけではない点に注意が必要です。
対策
クロス集計の守備範囲は層ごとの差を発見する段階までと割り切る
因果関係を主張する前に、別の属性軸でも層別して同じ差が出るかを確認する
因果の検証が必要な場合は、層別解析や回帰分析など別の統計手法に進む
5-3. 目的のない総当たりクロスを行う
リサーチクエスチョン(RQ)から外れた総当たりクロスは、偶然の差を量産して示唆を歪める原因になります。
なぜ起こるか
多数のクロス表を作れば、その中にはたまたま大きな%差が現れるセルが必ず出現します。そこを取り上げて意味づけしようとすると、偶然の差を起点に無理な解釈を組み立てることになります。
総当たりクロスはノイズを増やす結果になりやすい点に注意が必要です。
対策
クロス集計はリサーチクエスチョン(RQ)と仮説にもとづいて軸を選ぶ
軸を決める前に「この組み合わせから何を読み取りたいのか」を一文で言語化できるかを確認する
軸数は2軸を基本とし、3軸目以降(多重クロス)は明確な目的があるときだけ追加する
5-4. レポート内で行%表と列%表が混在した出力を作る
同じレポート内で行%表と列%表が混在すると誤読を招きます。
なぜ起こるか
レポートの中で横%表と縦%表が混在すると、読み手は表ごとに分母の向きを切り替えながら読まなければならず、誤読のリスクが高まります。
悪い例:同じレポート内で表の向きが混在
表1(性別×満足度/横%表)
性別 | n | 満足計 | どちらでもない | 不満計 | 計 |
男性 | 250 | 50% | 25% | 25% | 100% |
女性 | 250 | 40% | 25% | 35% | 100% |
表2(性別×利用意向/縦%表)
利用意向 | 男性 | 女性 |
n | 250 | 250 |
利用したい | 25% | 55% |
どちらでもない | 30% | 30% |
利用したくない | 45% | 15% |
計 | 100% | 100% |
同じ「性別×回答」のクロスでありながら、表1は横%、表2は縦%と分母の向きが異なります。読み手は表をまたぐたびに前提を切り替える必要が生じます。
良い例:レポート全体を横%表で統一
表1(性別×満足度)
性別 | n | 満足計 | どちらでもない | 不満計 | 計 |
男性 | 250 | 50% | 25% | 25% | 100% |
女性 | 250 | 40% | 25% | 35% | 100% |
表2(性別×利用意向)
性別 | n | 利用したい計 | どちらでもない | 利用したくない計 | 計 |
男性 | 250 | 25% | 30% | 45% | 100% |
女性 | 250 | 55% | 30% | 15% | 100% |
どの表も性別を分母にした横%で統一されているため、同じ前提で読み続けられます。
対策
レポート単位で%の方向を統一する。本記事のように属性別に層差を見るのが目的であれば、全表を横%表(行%)で揃える
例外的に方向を変える表があるときは、表注で「この表は縦%」「分母は性別」のように明記する
出力前に、レポート全体を通読して%の向きが揃っているかを最終チェックする
6. まとめ
クロス集計は、単純集計では捉えきれない回答者ごとの違いを構造的に読み解く、分析の基本となる手法です。本記事の要点を以下に整理します。
クロス集計は単純集計では見えない層ごとの違いを浮かび上がらせる:全体平均では隠れてしまう傾向を、属性や回答ごとに分けて読み解くことで、ターゲット層や課題を具体的に特定できます。
調査設計の段階からクロス集計の使い方を想定する:仮説と分析軸を事前に決め、セルあたりn=30以上を確保するサンプルサイズ設計を行うことが集計の質を大きく左右します。
クロス集計は分母の取り方で意味が決まる:属性別の層差を見るなら、属性を分母にした%で読むのが原則です。レポート内で%の方向を統一することが、誤読を防ぐ要点となります。
相関と因果を混同しない:クロス集計は層ごとの差を発見するまでが守備範囲です。要因の検証が必要な場合は、別の統計手法を使った分析が必要です。
QiQUMOのフィルター集計機能を使えば、その場で深掘りできる:特定の回答に絞った全体傾向をダッシュボード上で即時に確認できるため、複雑なクロス集計作業を介さずに仮説検証や追加分析の方向づけが可能です。
クロス集計を正しく使いこなすことは、アンケートデータの価値を最大限に引き出し、説得力のある施策へとつなげるための確かな一歩となります。意思決定の精度を高める分析手法として、ぜひ本記事の内容をご活用ください。