 お問い合わせ
この記事でわかること
- 市場・競合の把握やレビュー分析など、AIリサーチが役立つ6つの場面
- 情報の鮮度や回答の偏りなど、AIの出力を判断に使う際の注意点
- 判断を誤った場合の影響に応じた、AIリサーチとアンケート調査の役割分担
- 市場規模の推計、競合比較、調査票づくりでの具体的な組み合わせ方
マーケティングや商品企画の領域において、情報収集や市場分析にAIを用いるAIリサーチは、業務を効率化する日常的な手段として定着してきました。しかし、その手軽さの裏で、AI特有の情報の偏りや誤情報を無自覚に意思決定へ反映してしまうリスクについては、十分な対策が取られていないのが現状です。
AIリサーチの成果を十分に引き出すには、AIが得意とする処理の守備範囲を見極め、アンケート調査などで得られた一次情報と役割を分けて考える必要があります。AIリサーチが役立つ具体的な場面を整理したうえで、意思決定に用いる際の統計的・構造的な限界と、判断のリスクに応じたアンケート調査との組み合わせ方を解説します。
1. AIリサーチが役立つ6つの場面
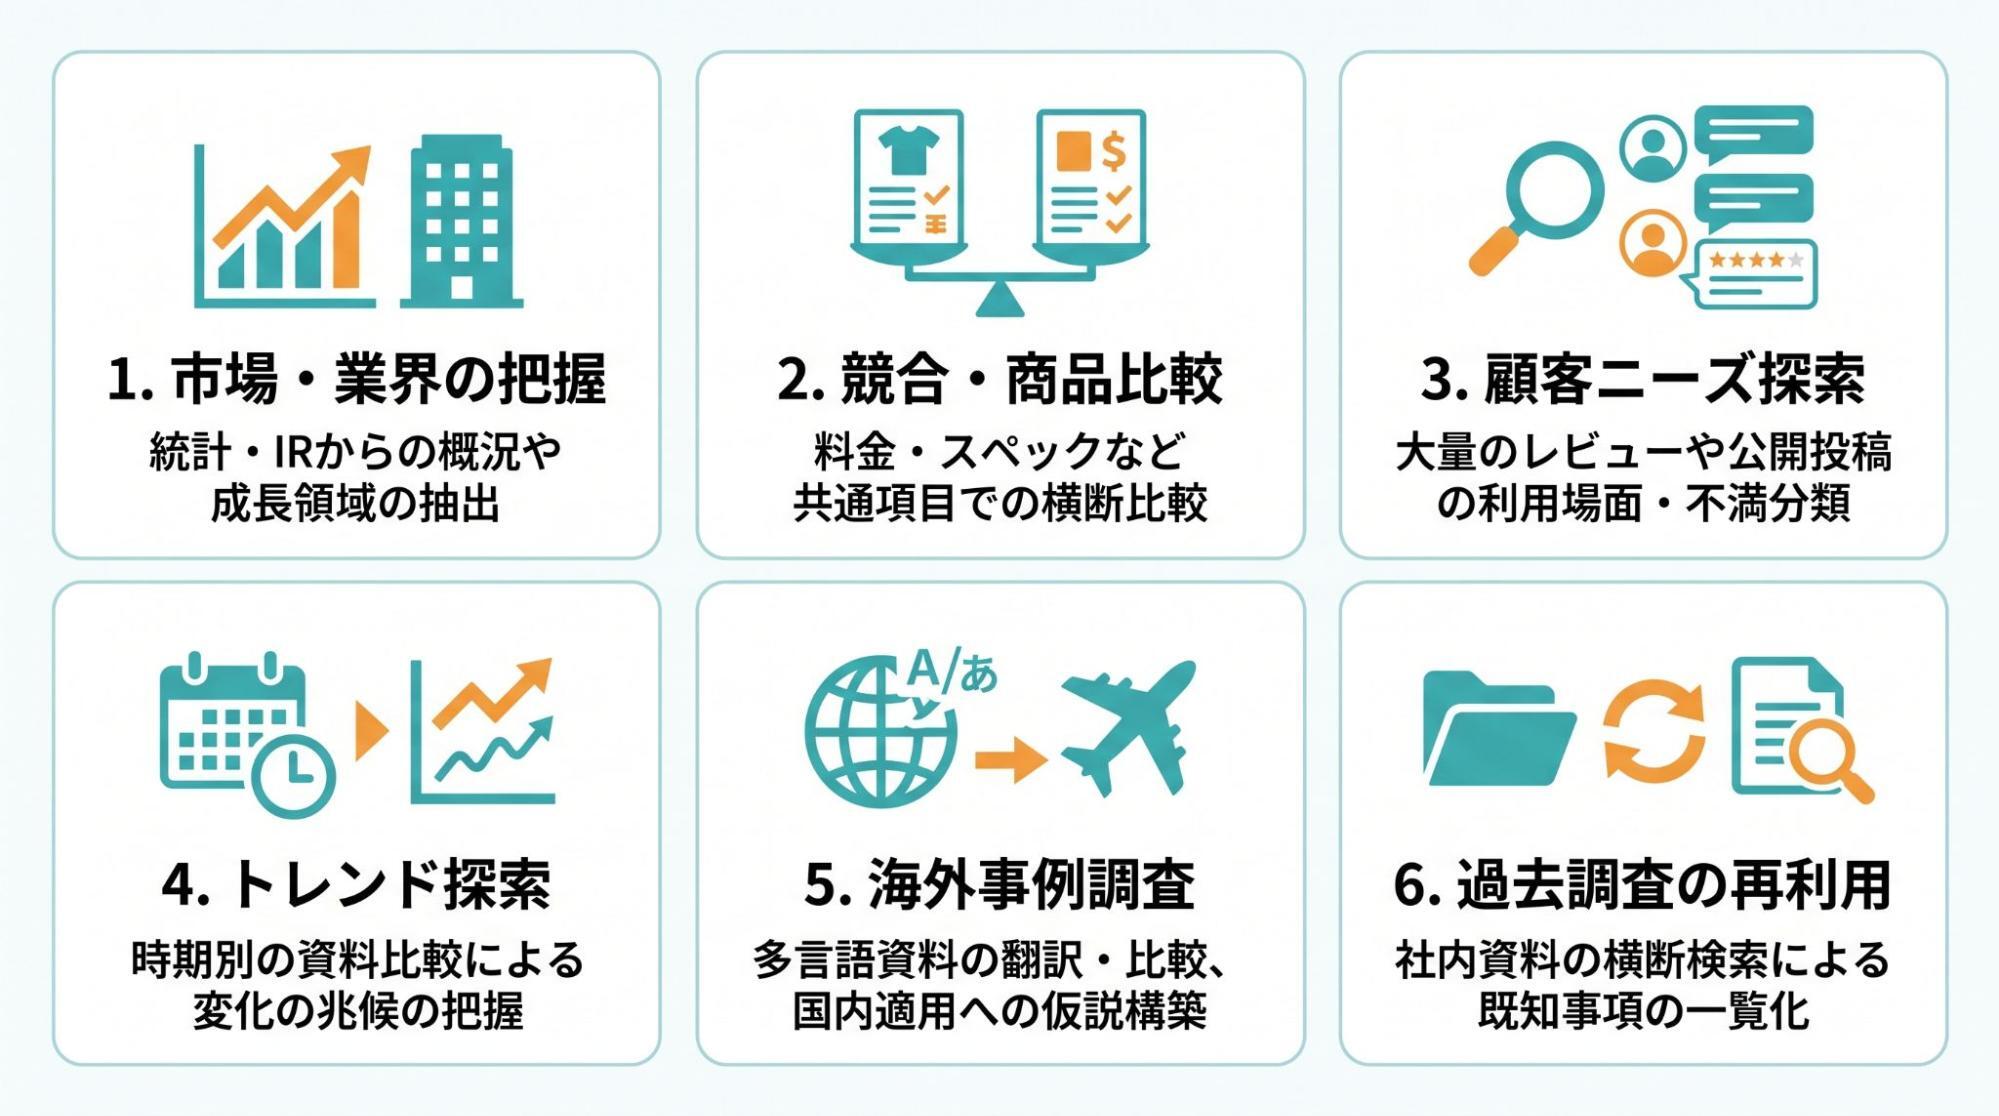
マーケティングリサーチでは、公開されている統計や業界資料、社内に蓄積された調査報告書などを確認し、市場や顧客について分かっていることと、追加で調べたいことを整理します。
資料を集めて読み解く工程では、AIリサーチが役立ちます。複数の資料から必要な情報を抜き出して比較する、大量のレビューを内容別に分類する、過去の報告書から関連する記述を探すなど、情報の収集・整理に活用できます。
|
用途 |
調べる問いの例 |
AIに任せる作業 |
得られる成果 |
|
1 市場・業界の把握 |
成長している分野、主要企業、流通経路は何か |
統計・業界資料・企業IRの数値や記述を抽出・分類 |
市場概況、業界構造、成長領域の候補 |
|
2 競合・商品比較 |
各社は誰に、何を、いくらで提供しているか |
商品ページ・料金表・広告を共通項目で比較 |
競合比較表、価格帯別の商品一覧、差別化の仮説 |
|
3 顧客の不満・ニーズ探索 |
利用者は何に困り、何を評価しているか |
取得したレビューや公開投稿を利用場面・不満・評価点で分類 |
ニーズの候補、改善テーマ、顧客が使う言葉 |
|
4 トレンド・変化の探索 |
新しい利用場面や購買行動が現れているか |
時期別の資料・投稿・ニュースを比較 |
変化の兆候、継続観察するテーマ |
|
5 海外・隣接市場の事例調査 |
海外や別カテゴリーでは同じ課題にどう対応しているか |
多言語資料の翻訳、事例比較、成立条件の整理 |
商品・サービスの着想、国内への適用仮説 |
|
6 過去調査の再利用 |
社内で分かっていることと未確認のことは何か |
過去の報告書を横断検索し、結論や対象条件を比較 |
既知事項の一覧、追加調査の論点 |
AIリサーチから得られる成果には、市場概況や価格帯別の商品一覧、既知事項の一覧のように元の資料から確認できる事実の整理と、差別化の仮説やニーズの候補、国内への適用仮説のように資料をもとにAIが生成した解釈・推測の2種類が含まれています。
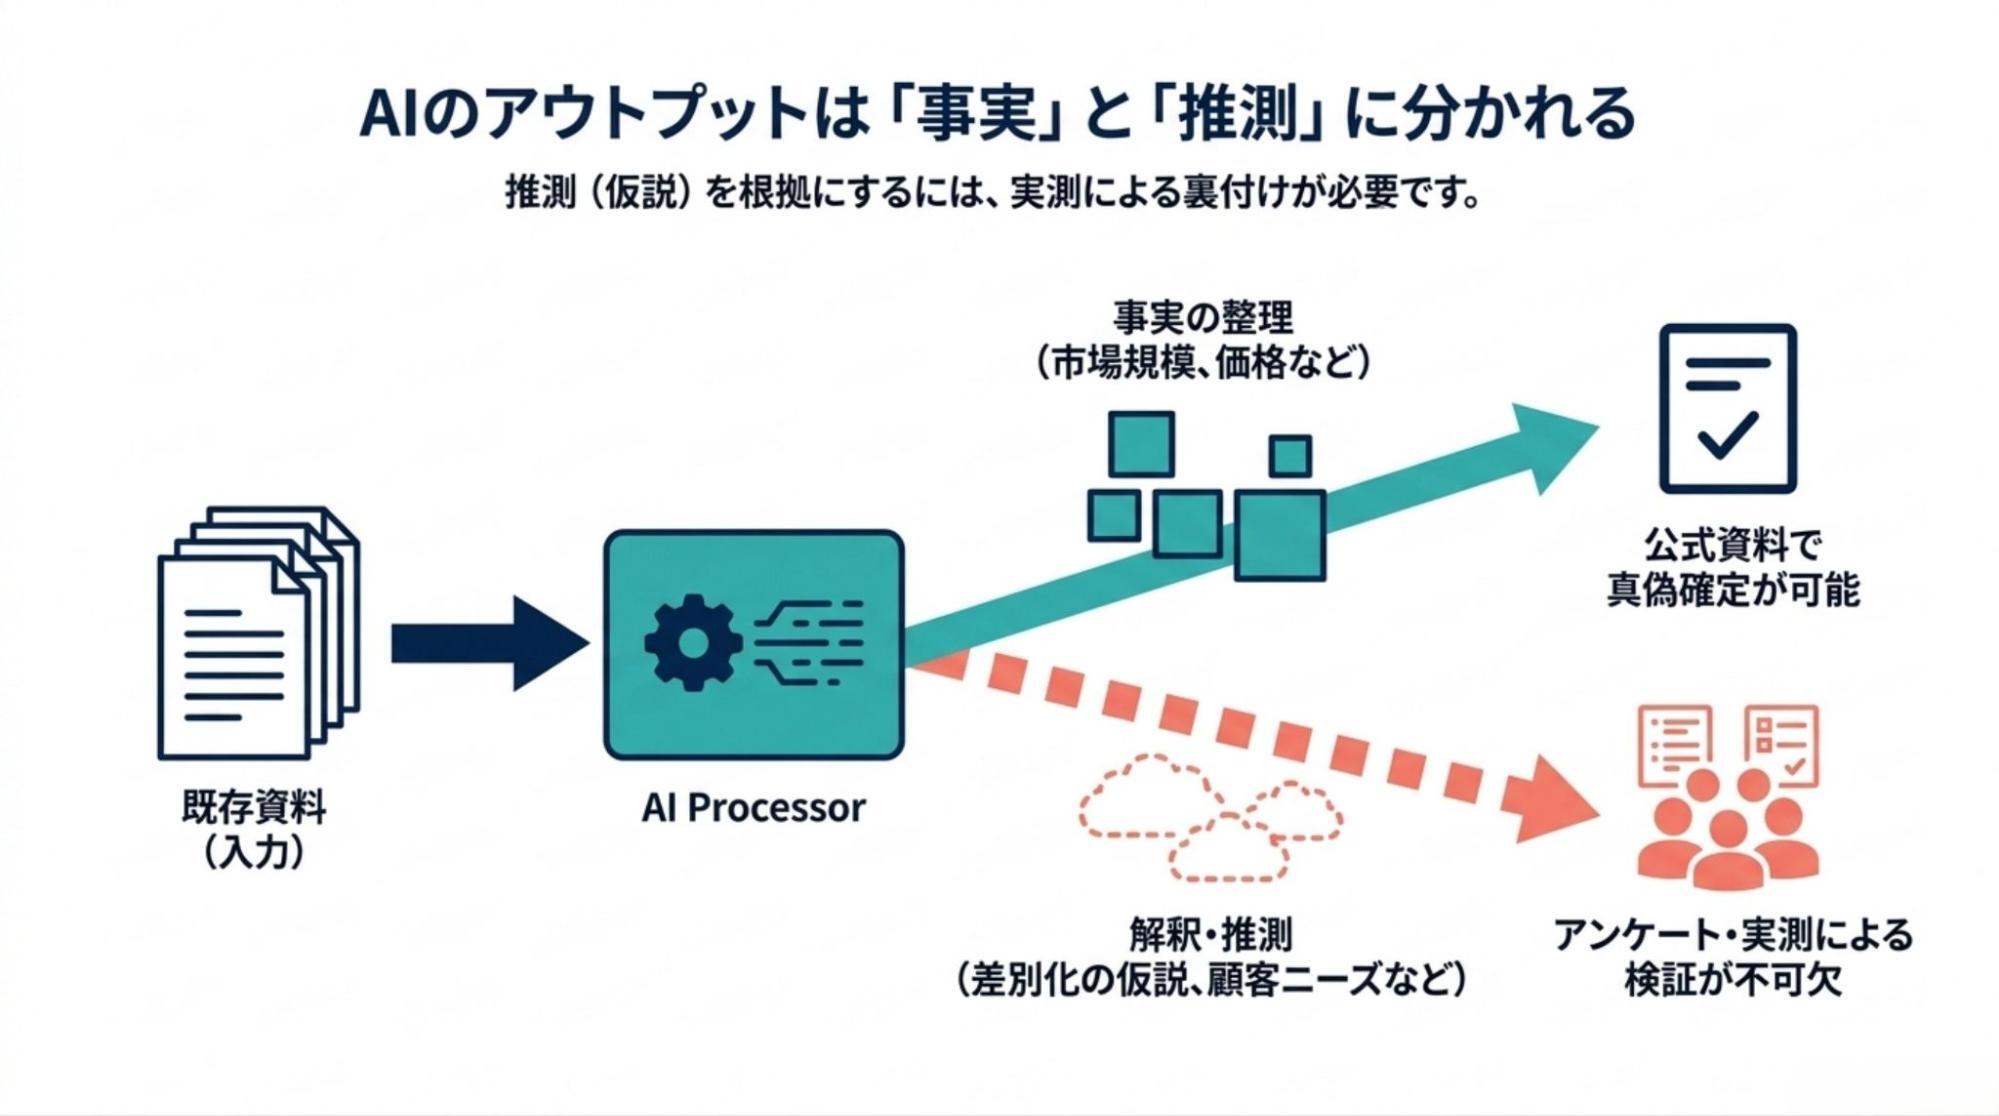
事実の整理と解釈・推測とでは、企画の根拠として採用する際に行う裏付けの方法が異なります。
元の資料から抽出された市場規模や競合価格といった事実は、参照元の公的統計や企業の公式資料と照合すれば真偽を確定させることが可能です。
対して、AIが導き出した顧客ニーズや差別化の方向性といった解釈・推測は、既存資料の記述から論理的に組み立てられた仮説にとどまります。
どれほど説得力のある文章で出力されていても、自社のターゲット層にそのまま当てはまる保証はなく、意思決定の根拠にするには実際の消費者を対象としたアンケート調査やテスト販売による検証が必要になります。
さらに近年では、公開情報の検索・要約にとどまらず、AIに特定の消費者属性を与えてアンケート回答や商品への反応を模擬させる手法も試みられています。
しかし、膨大な情報を高速に整理・推測する有用性と、対象顧客の実態を測る精度は別問題であり、切り分けて評価する必要があります。
2. AIリサーチの結果を判断に使う前に知っておきたい限界
公開情報の整理や消費者反応の推定をAIに任せ、その結果を企画の判断材料にする場合、AIの処理の特性や参照データの性質から生じる限界があることを知っておきましょう。
2-1. 学習時点より後の変化は、AIの回答に反映されない
AI(大規模言語モデル:LLM)には学習データの知識カットオフ(一定の時期までのデータしか学習していない境界)が存在します。カットオフ以降の出来事や新たに公表された情報は、学習済みの知識に含まれていない場合があります。
米国の調査機関であるPew Research Centerが2026年9月に公表した検証レポート( Synthetic surveys and timely and topical questions )では、人間の回答者の属性データをAIモデル(2025年5月までの知識を持つClaude Opus 4.6)に与え、2026年初頭の時事的・経済的な設問に対する回答を予測させる実験が行われました。
実験の結果、日常生活に関わる経済的な懸念事項や新施設への態度において、実際の人間とAIの予測との間に大きな乖離が生じています。
- 電気代上昇への懸念の過小評価
医療費(人間71%/AI84%)や食料品・日用品価格(人間66%/AI78%)ではAIがやや高めに出た一方、電気代上昇への強い懸念は人間52%に対しAI23%と、29ポイント低く見積もられました。
- データセンターの地域影響の予測ずれ
データセンターについて聞いたことがある人に地域への影響を尋ねた設問では、家庭のエネルギー費に悪影響があるとする回答が人間50%に対しAI99%でした。地域の雇用に悪影響があるとする回答は人間20%に対しAI0%で、AIは項目によって悪影響を過大にも過小にも見積もっています。
- 政治・国際情勢での急な態度変化の不一致
トランプ大統領の支持率では、共和党寄りの層でAIの推定が実際より最大19ポイント高く出ました。2026年2月末に始まったイランとの軍事衝突でも、米国の対イラン攻撃を支持する共和党寄りの層の割合は、人間67%に対しAI93%と26ポイント高く見積もられています。
知識カットオフは、利用時点より数か月前から1年以上前までなどAIモデルによって幅があります。
AIの学習済みの知識だけに頼って直近の出来事に関する二次情報を集めたり、市場の反応を予測したりする際は、最新情報の欠落や、予測と実際の回答とのずれに注意が必要です。
2-2. AIが推定した回答は、人間の回答の幅や割合とずれる
AIに消費者の属性を与えてアンケートに回答させると、特定の選択肢に回答が偏るなど、意見のばらつきや回答割合が実際の消費者への調査結果と異なる場合があります。
Pew Research Center(米)の包括的な検証( Can AI stand in for human survey takers? Not really )およびモデル間の比較検証( How synthetic polling results change based on the AI model )、さらに生体データ解析企業であるiMotionsのレポート( 真実、嘘、そして合成データ:市場調査 )では、主に4つの歪みが報告されています。
|
論点 |
検証で報告された事例 |
企画・分析における注意点 |
|
極端な反応の欠落と回答の集中 |
データセンターの認知度で、人間はよく知っている25%・少し49%・全く知らない26%に分散したのに対し、AIは少し知っているが94%に集中(Pew)。中絶を全条件で違法とする回答も人間11%に対しAIは0%(Pew)。 |
穏当な選択肢に回答が集まりやすく、強い賛否や熱狂的な支持・拒絶といった分布の両端が見落とされる。 |
|
不確実性の回避と知識量のずれ |
人間はAIの約4倍の頻度で確信がない選択肢を選択。政治や国際情勢の知識テストでも、人間が50〜60%台の正解率にとどまる設問でAIは82〜99%正解(Pew)。 |
AIはわからないという回答を避けて明確な選択肢を強引に選ぶため、実際の消費者に存在する未認知や理解不足、無関心を再現するのが困難である。 |
|
属性イメージの過度な適用 |
サッカーのワールドカップを追う可能性があるヒスパニック層の割合が、人間43%に対してAIは97%(Pew)。 |
特定の属性に対する典型的なイメージが100%近くまで誇張して適用され、同じ属性内にある個人差や多様性が消失する。 |
|
生成件数と実回答数の混同 |
30人の実データをもとに、AIで170件分の回答を追加生成して合計200件にするケース(iMotions)。 |
AIで生成件数を170件増やしても本質的な情報量は30人分のままであり、標準誤差の算出などの推測統計は成立しない。 |
回答分布の偏りはテキストの設問だけでなく視覚的な反応予測にも現れます。iMotionsの報告によると、AIによる視線予測(アイトラッキング予測)では画面の中央に視線が集中するバイアスが強く働き、実際の人間が示す画面周辺部への視線移動や独自の関心領域が削ぎ落とされる傾向が確認されています。
また、Pew Research Centerのモデル比較検証では、Claude Opus 4.6が実際より中道寄りで穏当な回答分布を作ったのに対し、GPT-5.1は実際より極端な意見に偏った分布を作るという逆方向の傾向が示されました。
採用するAIモデルの種類によって回答の強さや割合が変動するため、AIが算出したパーセンテージをそのまま市場の構成比として扱うことには大きなリスクが伴います。
2-3. 少数意見の重みや調査条件を取り違える場合がある
AIを用いてレビューの要約や既存調査の検索を行う場面でも、定性的な評価の歪みや条件の逸脱が発生することがあります。
株式会社日本能率協会総合研究所(JMAR)の記事( 消費者調査にAIをどう活用する?消費者インサイトを調べる際の注意点 )およびボストン コンサルティング グループ(BCG)のレポート( Want Consumer Insights Faster? AI Can Help )では、業務上の注意点として3つの事象が指摘されています。
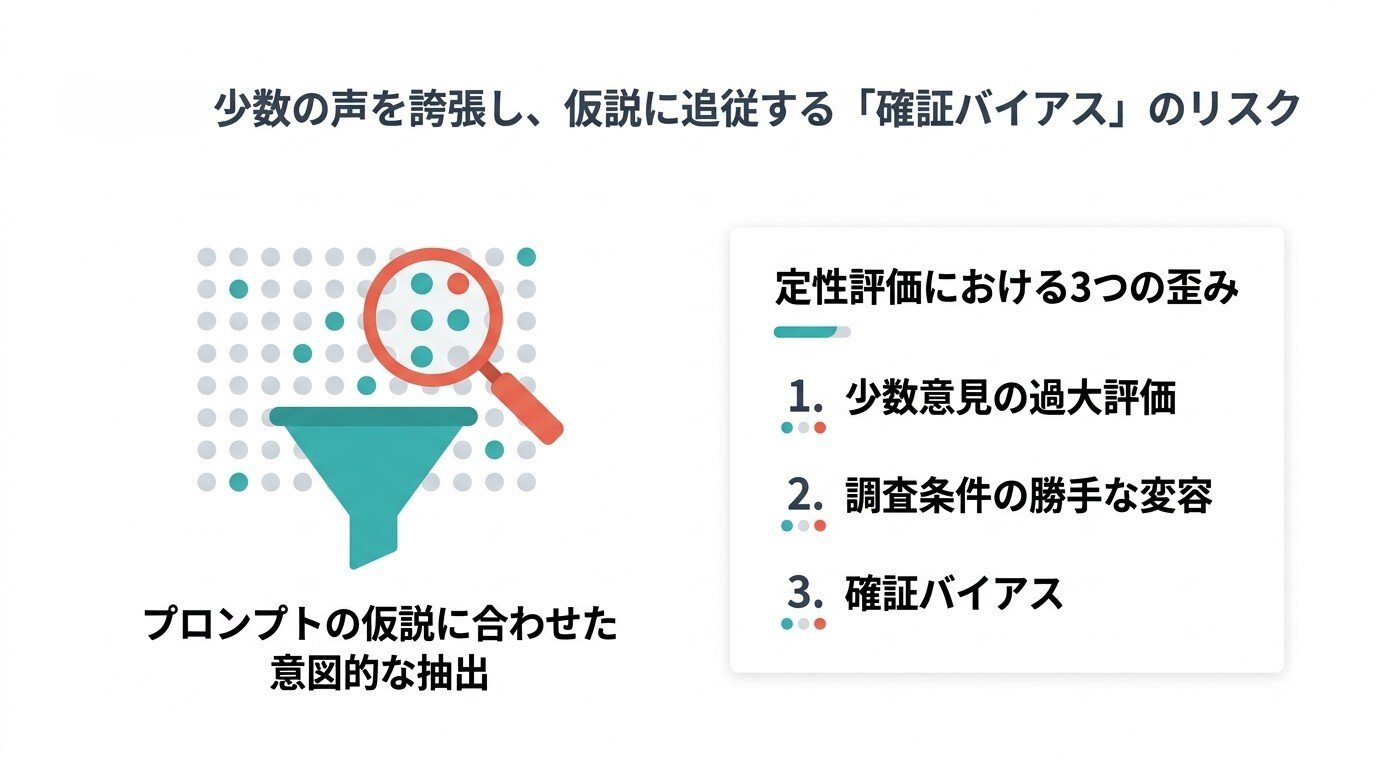
- 少数意見の過大評価
JMARの記事では、100件の商品レビューのうち批判的な意見が2件だけの場合を例に挙げています。AIは課題を探そうとして、その2件を肯定的な意見と同じくらいの温度感で、商品の課題として示すことがあるという指摘です。
AIが作成した要約文だけを読むと、ごく一部の例外的な不満を重要な改善テーマと誤認するおそれがあります。
- 調査対象条件の勝手な変容
男女共通の課題を調べる目的で検索や整理を指示したにもかかわらず、AIが女性限定で実施されたアンケート結果を抽出して回答を構成してしまうケースもJMARによって指摘されています。
AIとの対話を重ねる過程で、性別・年代・地域・購買経験といった対象者条件がいつの間にか変更・限定されてしまう事象です。
- 仮説への意図的な追従(確認バイアス)
BCGのレポートでは、AIが演じる回答者(合成回答者)が調査者の仮説を推測し、仮説を裏付けるデータを作ってしまう確証バイアス(Confirmation Bias)のリスクを挙げています。
調査の意図を回答者側のAIに読み取られると、検証のつもりで集めた回答が仮説の追認にとどまります。
AIが出力した要約やインサイトを評価する際は、テキストの結論だけをうのみにせず、参照元のデータにおける実際の言及件数、回答割合、および調査対象者の属性条件を人間側で直接照合する作業が求められます。
2-4. AIが参照した情報だけでは、必要な情報がそろうとは限らない
AIリサーチで収集・要約できる範囲は、アクセス可能な公開データや入力資料の枠内に限定されます。データソース自体の制約と、公開データが持つ偏りの双方が、判断材料の不足を生みます。
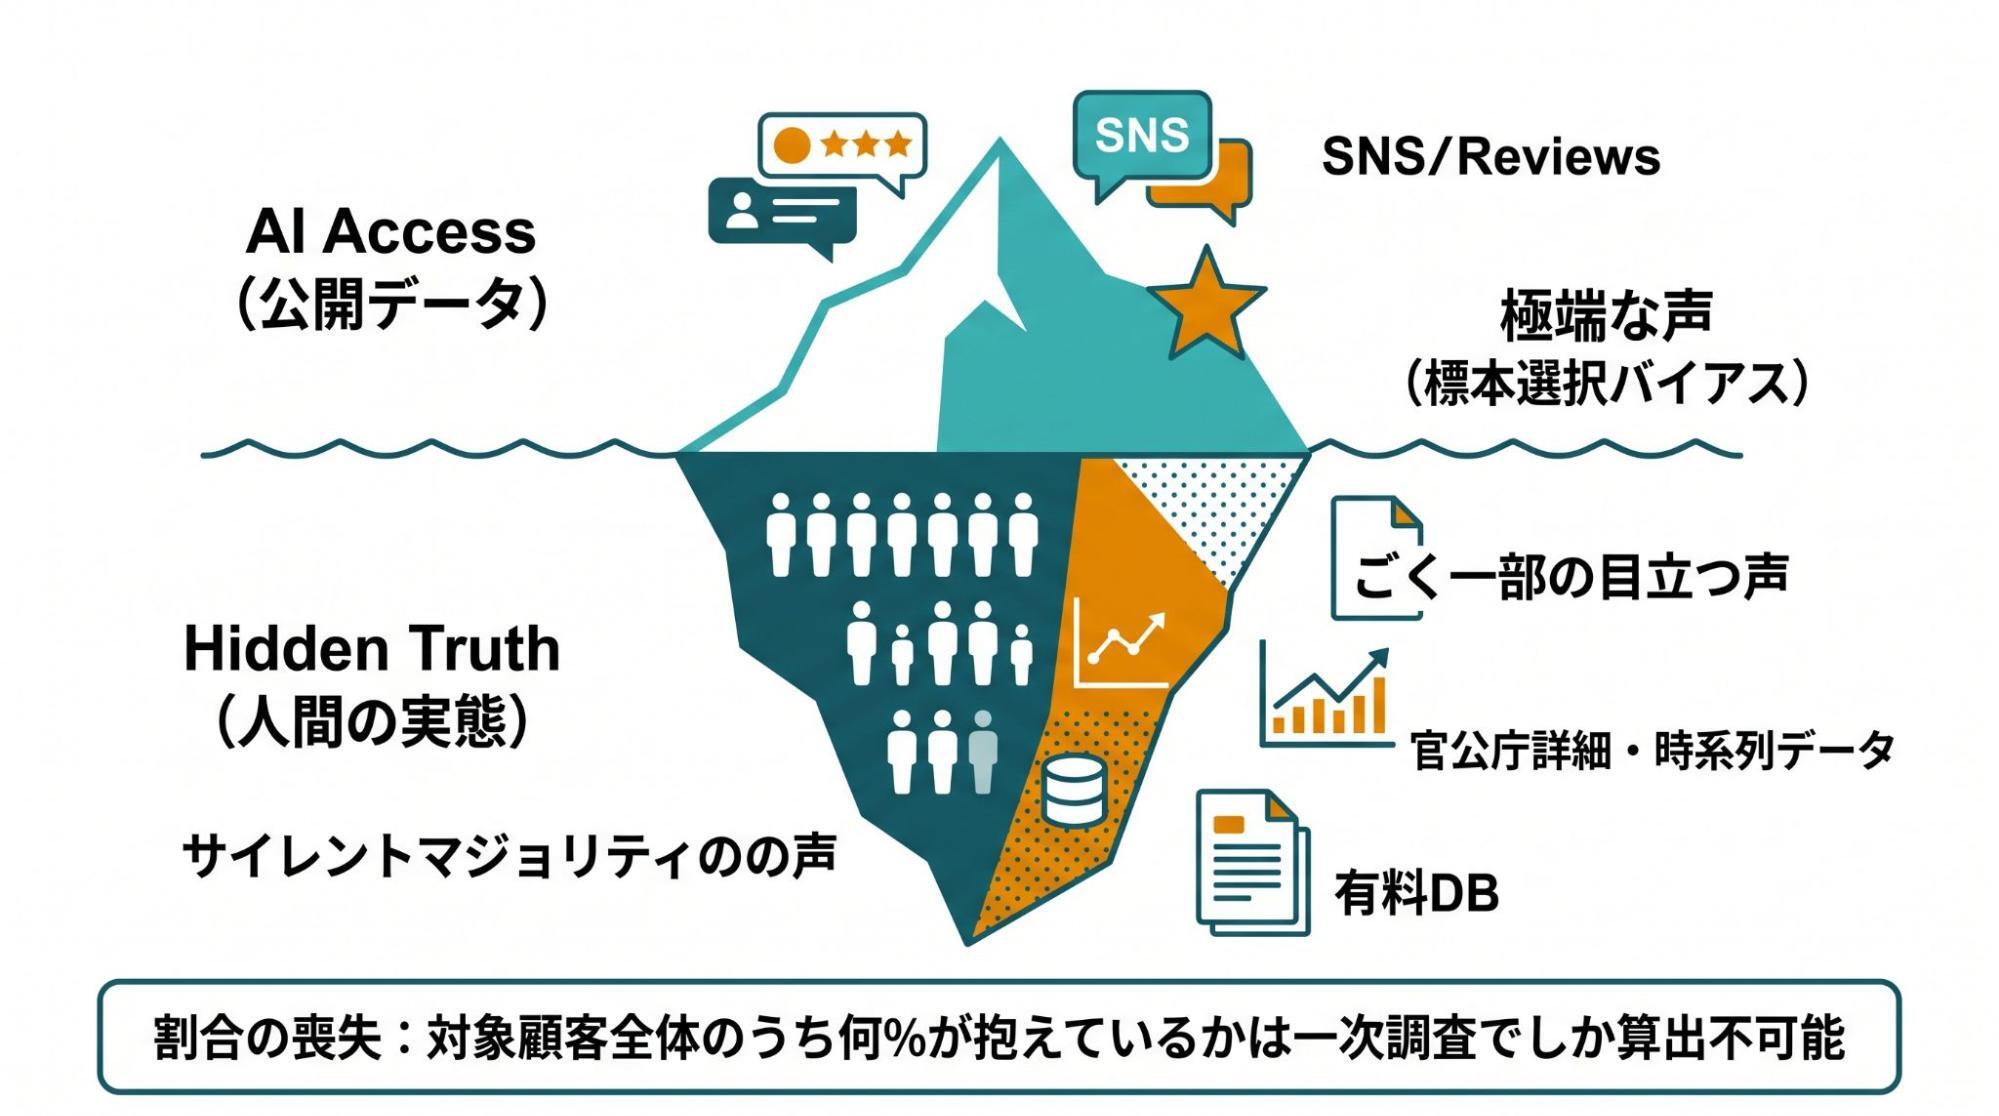
過去の時系列データや意識調査の推移、Web上に公開されにくい業界紙・専門紙・官公庁の詳細統計などは、AI検索で十分に取得できない場合があります。店舗のPOP設置効果や売り場の工夫による売上変化も、公開資料だけでは把握が難しい情報です。
有料データベースや新聞記事、学術論文なども、利用規約やアクセス権限によって収集が禁止・制限されている場合は参照対象から外れます。
また、ECサイトのレビューやSNSの投稿には、意見を自発的に発信する利用者への偏り(標本選択バイアス)にも注意が必要です。強い満足や不満を持つ人の声が集まる傾向があり、投稿しない購入者を含む顧客全体(母集団)とは意見の分布が異なる可能性があります。
AIが公開レビューの不満を正確に分類しても、把握できるのは投稿に現れた不満の種類です。顧客全体の何%が同じ不満を持つか、競合の訴求と消費者のブランドイメージにどの程度の差があるかまで、公開データだけで判断することは困難といえます。
自社のターゲット層における不満の出現率や購買時の重視点を把握するには、対象者の条件を定義したアンケート調査が有効です。一次データを集める際には、回答者の構成や設問による偏りも確認します。
3. 判断のリスクに応じて、AIリサーチと人間調査を組み合わせる
AIリサーチには情報の鮮度や回答の偏り、参照元の制約があるため、実際の対象者への調査と役割を分担して活用します。
AIに任せる範囲と、対象者への調査で確かめる範囲を決める基準は、判断を誤った場合の影響の大きさです。
3-1. リスクは、判断を誤った場合の影響で分ける
AIリサーチをどの程度まで意思決定の中心に据えるかは、作業の名称だけで一律に決まるものではなく、判断を誤った際に生じる事業上の影響度によって分類できます。
リスクの高低を見極める基準となるのは主に4つの観点です。
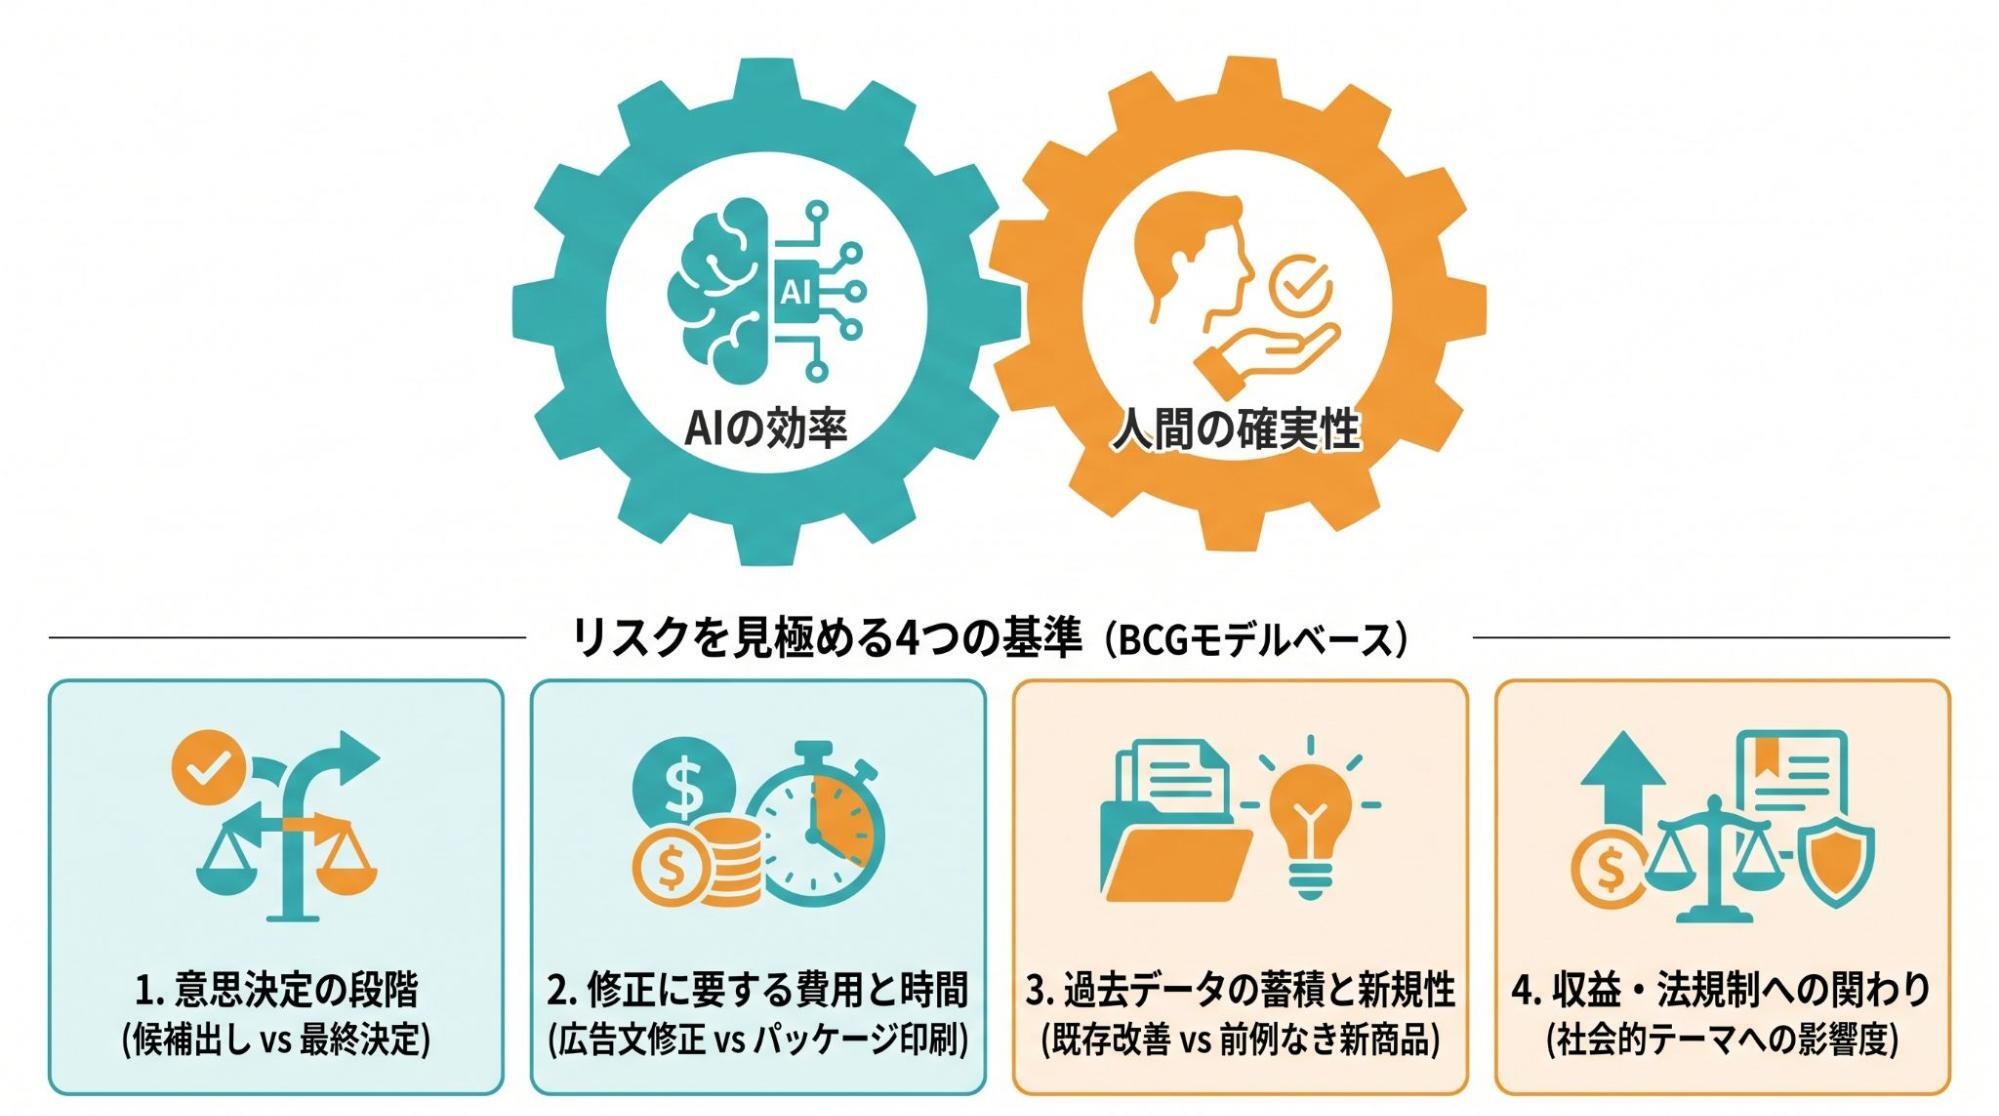
- 意思決定の段階
選択肢の候補を広く洗い出す初期段階か、あるいは最終的な仕様や発売の可否を決定する段階かによって求められる精度が異なります。たとえば商品名の検討でも、100案の候補を出す作業と最終的な1案に絞る判断とでは、誤った際の影響度に大きな差があります。
- 修正に要する費用と時間
判断の誤りが判明した後に、軌道修正ややり直しにどれだけの資金と期間が必要になるかという観点です。Web広告の文言変更のように少額かつ短期間で差し替えられる施策と、製造ラインの確保やパッケージ印刷を伴う商品発売とではリスクの水準が異なります。 - 過去データの蓄積と新規性
既存の市場や定番商品の改善のように過去の販売データや調査結果が豊富な領域に比べ、前例のない新カテゴリーの商品や画期的な概念を扱う領域では、過去データを学習したAIの予測精度が低下します。 - 収益・法規制・社会的テーマへの関わり
売上や需要の直接的な予測、薬機法(医薬品医療機器等法)や景品表示法などの法規制に関わる表現の検証、あるいは時事的で社会的な関心が強いテーマを扱う場合は、予測のずれが業績の悪化や信用の失墜に直結します。
3-2. 低・中・高リスク別に役割を整理する
ボストン コンサルティング グループ(BCG)が公表した消費者インサイト活用に関するレポート( Want Consumer Insights Faster? AI Can Help )では、新商品開発などにおける意思決定のリスクを低・中・高の3段階に分け、AIと人間を対象とした調査の関与度を変える枠組みが提示されています。
BCGの3段階分類を基礎としつつ、公開情報の検索や要約も含めたAIリサーチ全般の業務に当てはめて役割分担を整理します。
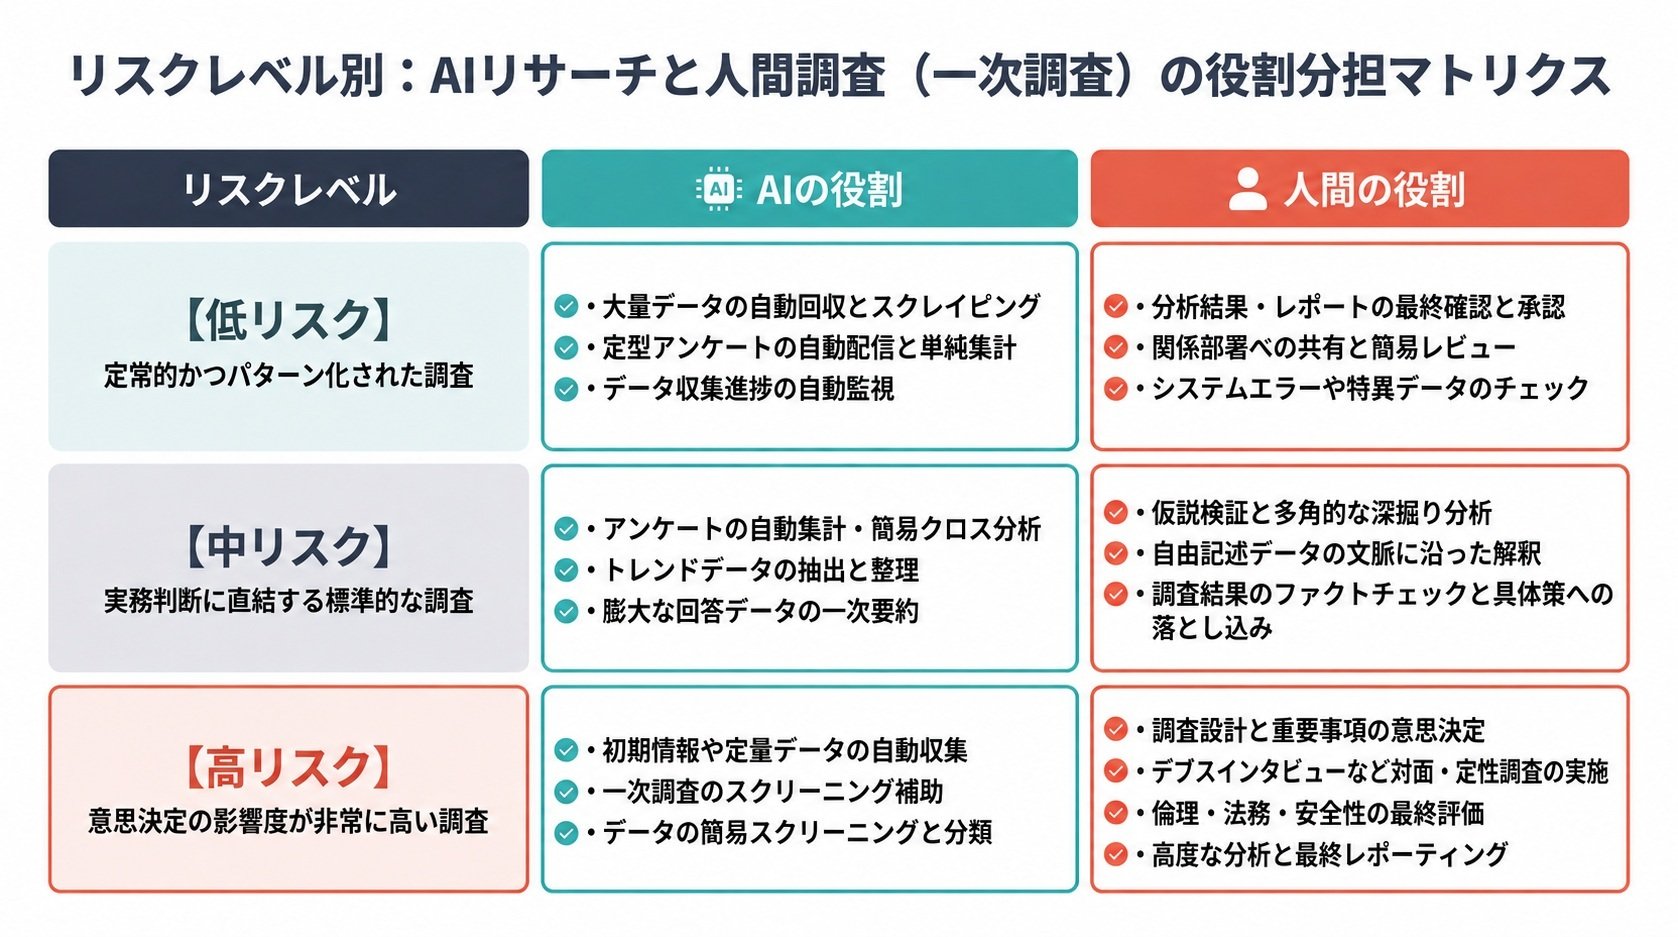
- 低リスクの領域
AIリサーチを主たる手段として活用し、検討の速度を高める運用が適しています。新商品のアイデア出しやネーミング案の列挙、公開レビューからの課題抽出といった初期工程では、AIに大量の候補や比較軸を出させて選択肢を絞り込み、残った有力候補に対して人間側で違和感の有無やターゲット層への適合性を確認する流れが効率的です。 - 中リスクの領域
AIリサーチを人間調査の補完役に位置づけます。パッケージデザインの選定や、オーガニック仕様の追加といった特定の製品属性の評価、複数の価格帯・割引案の事前比較などが該当します。AIリサーチで競合商品の状況や消費者の反応に関する仮説を組み立てて検証対象を絞り込んだうえで、実際の対象顧客に向けたアンケート調査やA/Bテストを実施し、評価や購入意向の割合を測定します。 - 高リスクの領域
人間から直接取得した一次データや原典の確認を判断の中心に据え、AIリサーチは背景情報の整理や検討シナリオの洗い出しといった補助的な用途にとどめます。たとえば価格や販促に関する検討でも、複数の案から方向性を比較する段階であれば中リスクとして扱えますが、最終的な販売数量や売上金額の予測、収益モデルの策定に用いる段階では高リスクに移行します。
法規制に関わる訴求の検証や、物価変動・社会情勢の影響を受ける意識調査、市場に前例のない商品の判断においても、対象者を定義したアンケート調査や試験販売、公式資料の原典照合が不可欠です。
3-3. アンケートで確かめる問いを切り分ける
AIリサーチで整理した情報や仮説のうち、人間側で追加の裏付けを行う対象は、確かめたい内容の性質によって4つの確認方法に切り分けられます。
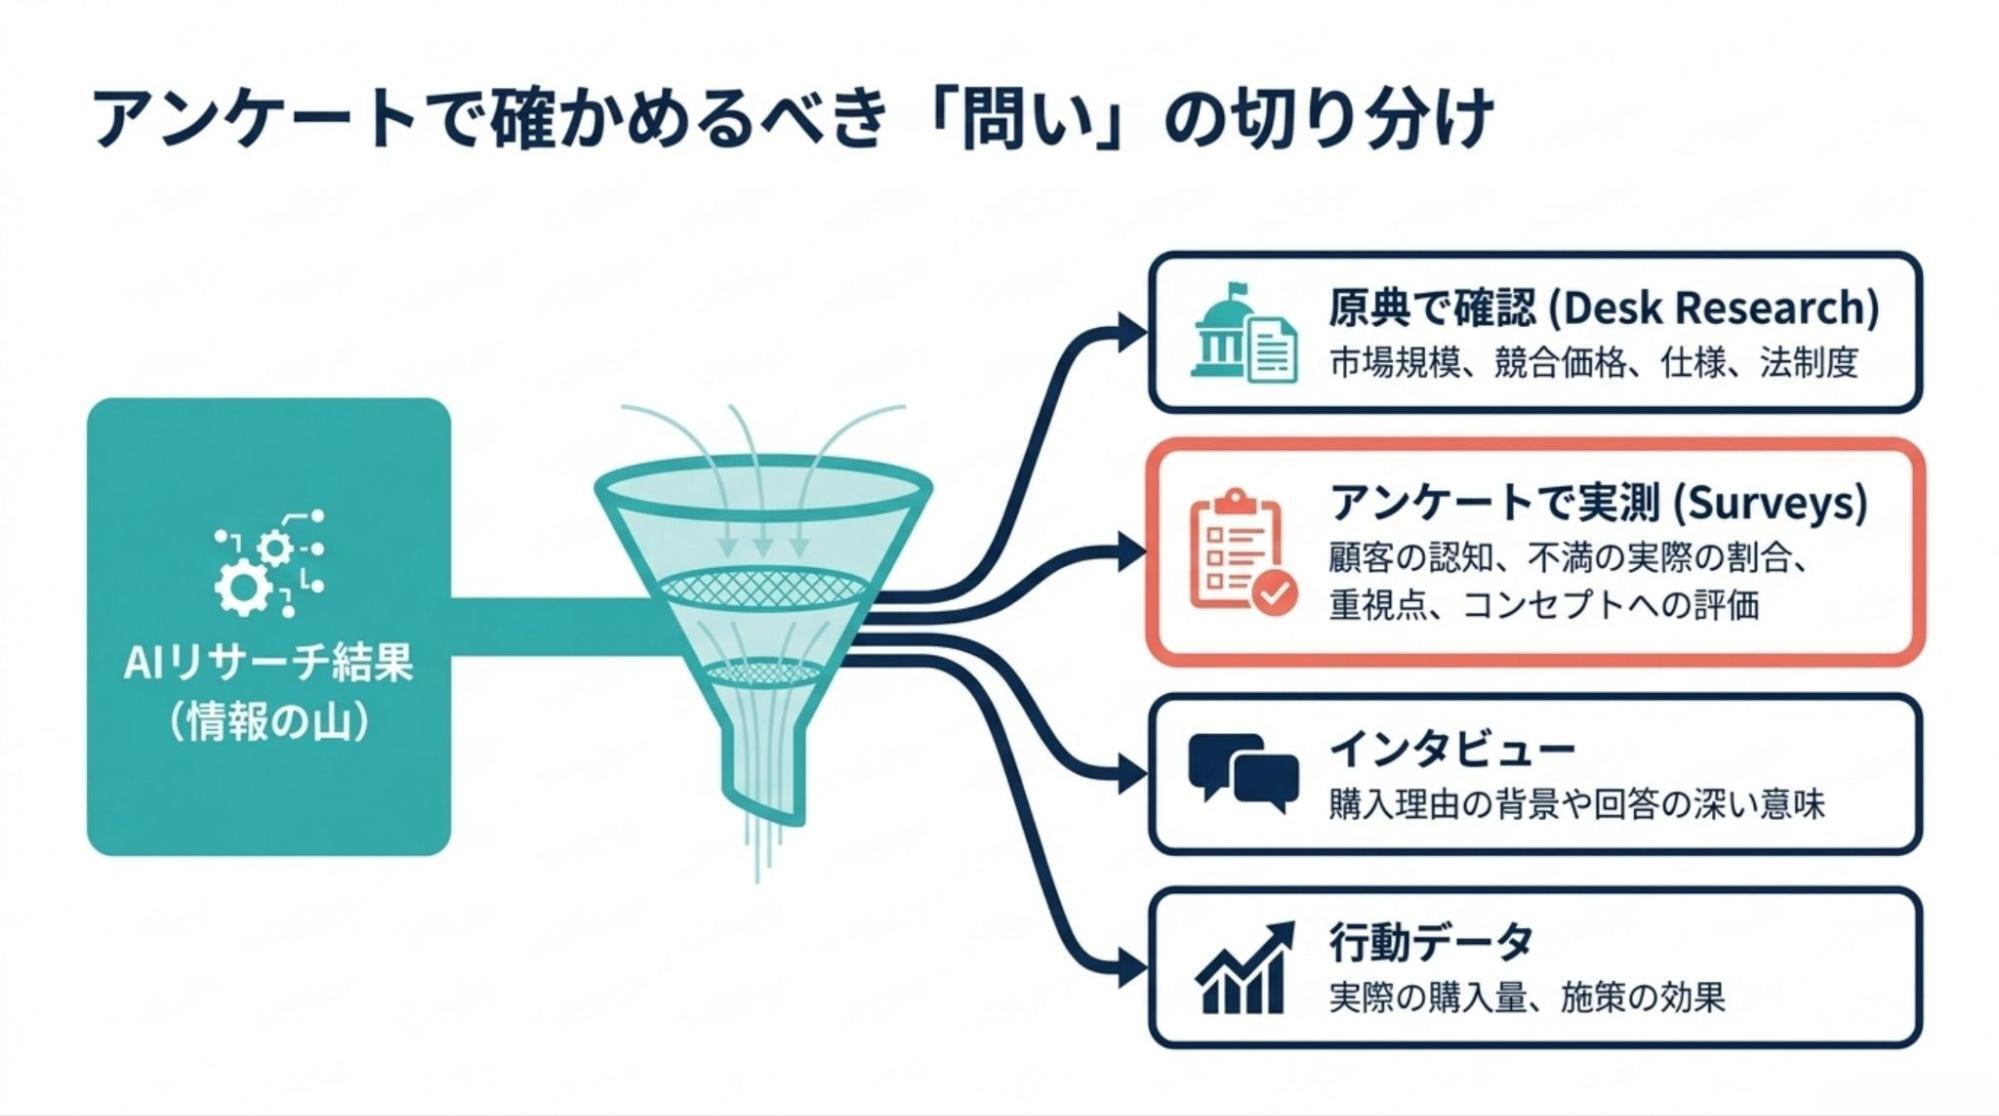
市場規模や競合商品の価格・仕様、法制度などの事実は、公的統計や企業の公式発表など、元の資料で照合する項目です。数値や記述の正確さに加え、資料の公表時期や調査対象の条件も確認します。
一方、アンケートで確かめるのは、ターゲット顧客の認知度や利用経験、不満の割合、購買時の重視点、商品案や訴求案への評価などです。性別・年代・居住地・購買履歴などの対象者条件を決め、統一した設問で回答を集めることで、現在の意識や評価を数値で捉えます。
アンケートの結果を判断に使うには、対象者の選び方や質問文への配慮も必要です。回答者の構成に偏りがないか、特定の回答を促す表現になっていないかを確認し、調査目的に合う設問を組み立てます。
購入意向は回答者の自己申告であり、実際の購買行動とは区別して扱う情報です。販売量や施策の効果を検討する段階では、購買データや試験販売の結果も組み合わせて判断します。
4. AIリサーチとアンケート調査を組み合わせる
AIリサーチで得た情報や仮説は、アンケートで何を尋ね、どのような選択肢を示すかを考える判断材料になります。
市場規模の推計やニーズの検証、競合比較への顧客評価の追加、レビュー分析を生かした調査票づくりを例に、AIリサーチとアンケート調査の具体的な組み合わせ方を解説します。
4-1. AIが集めた事実と推論を、一次情報で裏付ける
市場概況や業界構造、競合商品の価格・仕様は、AIを使って整理できる情報です。出力された数値や出典に誤りが含まれる場合があるため、元の統計や企業の公式資料と照合します。
特に市場規模の数値は、情報源によって入手方法や公開範囲が異なる点にも注意が必要です。
- メディア報道・企業の公開資料
古い数値や他の資料からの引用が含まれるため、元の出典と調査時期を確認します。
- 調査会社の有料データ・レポート
AI検索で取得できる数値は、プレスリリースなどで公開された一部に限られる場合があります。
- 業界団体の統計
会員限定などの非公開データは、閲覧権限のないAI検索では取得できない情報です。
- 新しい市場・ニッチな市場
まとまった統計がなく、市場規模の数値が見つからない場合もあります。
AI検索から信頼できる数値が得られない場合や、参照元の情報の信憑性が低い場合には、消費者向けのアンケート調査を実施して需要側から市場規模を推計するアプローチを取ります。
推計の計算式と設問設計は1通りではなく、対象となる商品の性質(既存商品か新商品か、購買頻度の高低など)や、信頼できる上位カテゴリー統計の有無に応じて、主に5つの方法から選択します。
|
方法 |
主な質問項目 |
市場規模の計算式 |
向いている場面・注意点 |
|
① 支出額を直接聞く |
一定期間に対象商品へ支払った合計金額 |
対象世帯数 × 全世帯の平均年間支出額 |
支出を把握できる既存商品。購入していない世帯も支出ゼロで平均に含める |
|
② 購入率と購入者の支出額を組み合わせる |
期間内の購入有無、購入世帯の年間支出額 |
対象世帯数 × 年間購入世帯率 × 購入世帯の平均年間支出額 |
購入者が限られる商品。購入率を測る調査と、購入者への詳細調査を分ける設計も可能 |
|
③ 購入頻度・数量・単価から積み上げる |
年間購入回数、1回の購入数量、実際の購入単価 |
対象世帯数 × 購入世帯率 × 購入世帯の平均年間購入金額 |
食品・飲料・日用品など。年間購入金額を回答者ごとに頻度・数量・単価から算出する |
|
④ 上位カテゴリー市場から切り出す |
カテゴリー内で対象商品に使った金額、カテゴリー全体への支出額 |
既知のカテゴリー市場規模 × 対象商品の金額構成比 |
上位カテゴリーの市場規模が信頼できる場合。購入者の割合と金額構成比は区別する |
|
⑤ 購入意向から将来需要を予測する |
商品説明・価格を提示した後の購入意向、予定数量・頻度 |
対象者数 × 購入意向率 × 実購買への移行率 × 購入者の予想年間購入金額 |
新商品や未形成の市場。移行率は、過去の類似商品で購入意向と実際の購入率を比べた実績値から設定する |
たとえば、年間の総額を記憶しやすいサービスや耐久財であれば支出額を直接尋ねる方法(①・②)が適していますが、食品や日用品のように少額の買い物を繰り返す商材では、購入頻度・数量・単価に分けて尋ねてから合算する方法(③)をとるほうが回答のブレを抑えられます。
また、公的統計や調査レポートで上位カテゴリー全体の市場規模が判明している場合は金額構成比から切り出す方法(④)、まだ市場に存在しない新商品の場合は購入意向から予測する方法(⑤)を用います。
どの推計方法を採用する場合でも、集計時には以下の2つの統計的な前提を踏まえて数値を扱う必要があります。
- 母集団の構成比に合わせた重み付け(ウエイトバック集計)
アンケートの回収サンプルと実際の母集団(公的統計における全国の世帯構成や人口動態)とで属性の割合が乖離している場合、特定の層の回答傾向に推計値が引っ張られてしまいます。
世帯単位で推計する際(①〜③)は世帯主年代や世帯人数の構成比、個人単位で推計する際(⑤)は性別・年代・居住地域の構成比を公的統計にそろえるウエイトバック集計を施します。
- 記憶の曖昧さや自己申告による誤差の考慮
過去の購入回数や支出額は回答者の記憶に依存するため、実際の購買履歴とは一定のズレが生じます。
新商品の需要予測(⑤)で用いる購入意向は、アンケート上で買いたいと答えた人が実際に購入するとは限らないため(3-3節参照)、過去の類似商品の実績値などから厳しめの移行率を掛け合わせ、推計値に上限・下限の幅を持たせて解釈することが求められます。
市場規模のような数値データだけでなく、AIが導き出した顧客ニーズや差別化の方向性といった解釈・推測についても、既存資料の記述から論理的に組み立てられた仮説にとどまります。
AIの推測をそのまま企画の根拠に据えるのではなく、そのニーズや不満を抱える層が実際のターゲット顧客全体のうち何%存在するのかをアンケート調査で定量的に測定し、一次データによる裏付けを取ります。
4-2. AIで整理した競合の比較軸に、アンケートで顧客の評価を重ねる
AIは競合各社の商品ページや広告から、訴求している機能・価格・ベネフィットを抜き出し、共通の評価軸で一覧表に整理する作業を得意とします。
しかし、AIが作成した比較表には構造的な限界が2つあります。
一つはAIは、ページ上の文字を平面的に処理するため、企業のメイン訴求とスペック表の隅にある付帯機能を同列に並べたり、書かれていないベネフィットを勝手に推測して表を埋めたりする歪みが生じます。
もう一つは、比較表から読み取れる範囲の限界です。人間が元の商品ページと照合して正確な比較表を作ったとしても、わかるのは企業側が何を主張しているかという供給側の事実にとどまります。
競合が訴求している機能を消費者も求めているとは限らず、逆に競合が触れていない項目が単に関心の低い要素なのか、まだ誰も満たせていない潜在ニーズなのかは、公開情報の分析だけでは判別できません。
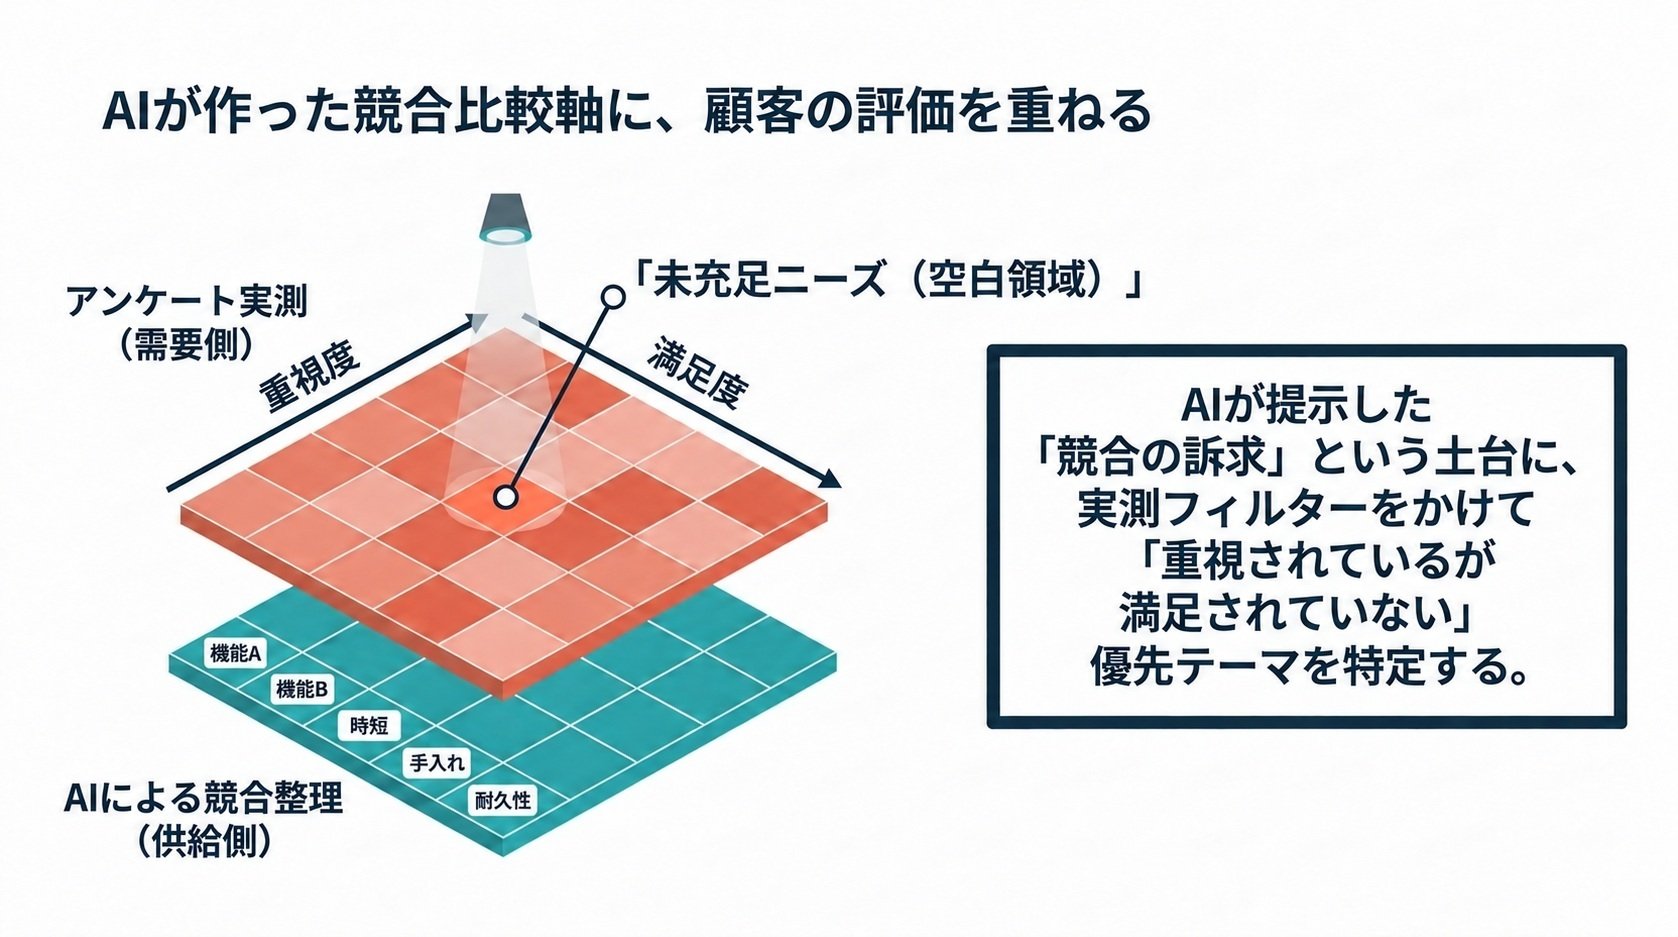
競合との差別化の方向性を定めるには、AIで整理した供給側の比較軸(機能・ベネフィット・価格)を土台にしつつ、アンケート調査を通じて需要側の評価を重ね合わせるアプローチが求められます。
具体的には、AIが抽出した機能・スペックに対しては、購買時の重視度と現在使用している商品への満足度を掛け合わせて測定し、重視されているにもかかわらず既存商品では不満が残っている空白領域(未充足ニーズ)を切り分けます。
同様に、ベネフィット・訴求表現については、各社のキャッチコピーや自社の訴求案をターゲット層に提示して魅力度や共感度を定量比較し、価格・プラン構成については、特定の機能や便益が付加された際にいくらまで支払う意思があるかという価格受容性を測定します。
たとえば調理家電の調査において、競合10社のうち8社が多機能性を打ち出し、手入れの簡便さを訴求する企業が2社だけだったとします。
ここでターゲット層へのアンケートを実施し、手入れの簡便さに対する重視度が高く既存製品への満足度が低い(未充足ニーズがある)こと、さらに洗い物削減のメッセージへの魅力度や追加支払い意欲も高いことが一次データで確認できれば、手入れの簡便さを軸とした企画が有力な差別化戦略として成立します。
4-3. AIで分類したレビューの不満や評価軸を、調査票の設問と選択肢に組み込む
AIリサーチで収集・分類したECサイトのレビューやSNSの投稿内容は、アンケート調査票を作成する際の土台として活用できます。この手法が有効に機能するのは、主に2つの場面です。
- 競合商品やカテゴリー全体のレビューから評価の枠組みを抽出する場面
新商品を企画する段階や自社商品のレビュー数が少ない段階では、競合商品や市場全体の口コミをAIで分類し、消費者がどのような観点で商品を評価しているかを洗い出します。
- 自社商品のレビューに現れた不満の出現率を定量化する場面
自社商品のレビューに特定の不満が書き込まれている場合でも、それが購入者全体の何%に当てはまるのかは口コミの件数だけでは判別不可能です(2-4節参照)。
仕様変更などの投資判断を行う前に、レビュー上の不満を選択肢に据えて購入者全体へアンケートを実施し、実際の発生割合を確かめる必要があります。
調査担当者の想定だけでアンケートの選択肢を作成すると、実際の利用者が感じている細かな不満や利用場面が漏れ、結果として「その他」や「特にない」に回答が埋もれやすくなります。
AIによるレビュー分析を挟むことで、市場に存在する評価軸を網羅した選択肢の設計が可能です。
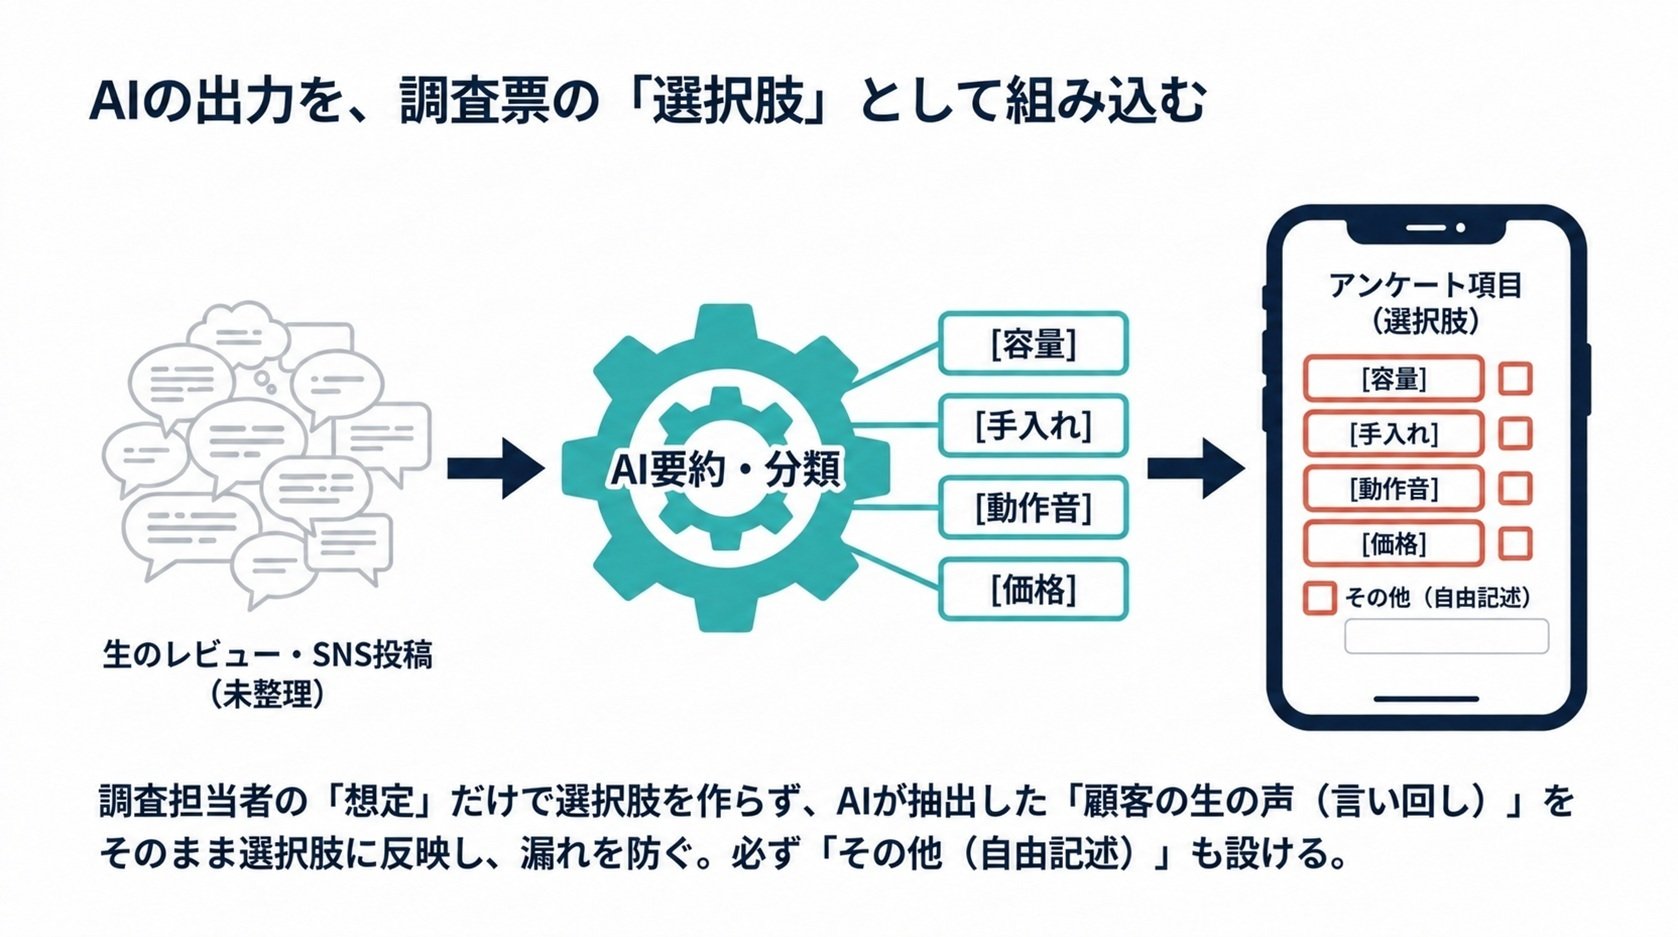 たとえば調理家電のレビューをAIで要約・分類した結果、画像のとおり「容量」「手入れ」「動作音」「価格」という4つの不満カテゴリーが抽出されたとします。
これらを調査票の選択肢に落とし込む際は、単なる単語を並べるだけでなく、レビュー内で頻出していた顧客の具体的な言い回し(例:「一度に家族全員分を作れない」「パーツの溝が洗いにくい」「夜間に使うと音が響く」など)を文言に反映させます。
普段使っている言葉に近い表現が並んでいれば、回答者は自身の感覚に合う項目を迷わず選択できます。あわせて、AIの整理から漏れた未知の不満を拾い上げるため、自由記述付きの「その他」の選択肢も設けておきます。
また、抽出した選択肢を誰に尋ねるかという対象者条件(スクリーニング設問)や、設問全体の構成を組む工程でもAIが役立ちます。
たとえばレビューの中で「共働き世帯での夕食準備」や「単身世帯でのまとめ作り」といった利用背景ごとに異なる不満が出ている場合、それらの属性や利用頻度をスクリーニング条件として切り分けます。
セルフ型アンケートツールQiQUMOに搭載されている「QiQUMO Ai」( 入力から設問生成までの流れを実例で解説 )では、調査したいテーマや対象者、調査の目的・背景を入力すると、AIがマーケティング課題や仮説を整理したうえで、調査の柱となるコンセプトと具体的な質問項目・選択肢を自動生成します。
事前にレビュー分析で得た不満の傾向や仮説を背景情報として入力し、出力された設問案に対してチャット形式で顧客の言い回しを追加・調整すれば、調査目的に沿った調査票を短時間で構築できます。
AIリサーチに関するFAQ
Q1. 自社の販売データや顧客リストをAIに読み込ませてリサーチに使っても問題ないですか
A.入力したデータが学習に使われる設定のサービスでは、顧客情報や売上などの機密が外部に残るリスクがあります。
利用するツールのデータ取り扱い規約を確認し、入力内容を学習に使わない法人向けプランやオプトアウト設定を選びます。個人情報や取引先に関わるデータは、匿名化や集計済みの形にしてから渡す運用が安全です。
Q2. プロンプトを工夫すれば、AIリサーチの限界は解消できますか
A. 指示文を具体的にすれば出力の精度はある程度上がりますが、本文で挙げた限界の多くはプロンプトでは解消しません。
知識カットオフ以降の情報が欠けること、公開データに現れない母集団の割合を測れないことは、AIモデルの構造やデータの制約から生じるためです。プロンプトの改善でAIリサーチの質を高めつつ、重要な判断では一次データで確かめる前提は変わりません。
Q3. シンセティックユーザーやデジタルツインを使えば、アンケートはAIで代替できますか
A.AIに消費者を演じさせて回答させるシンセティックユーザーや、個人の属性・嗜好を持たせて反応を予測させるデジタルツインは、調査の低コスト化と高速化の手段として注目されています。
ただし現時点の検証では、回答が平均的な値に寄って個人差や極端な意見が失われる、前例のない商品への反応をうまく再現できないといった弱点が報告されています。(2章参照)人間の回答を置き換えるより、補助的に使う位置づけが現実的で、重要な判断では一次データによる確認が引き続き必要です。
5. まとめ
AIリサーチは、公開データの整理や競合比較、レビュー分類といった調査の準備工程を短時間で進めるのに有効な手段です。 一方で、知識カットオフによる情報の古さや回答分布の偏り、参照データの制約といった限界もあり、出力された内容をそのまま市場の実態として扱うことにはリスクが伴います。
AIが整理した内容は、原典から確認できる事実と、資料をもとに組み立てた解釈・推測の2つに大別できます。 事実は公的統計や企業の公式資料で照合し、解釈・推測はターゲット層へのアンケート調査で裏付けるのが基本の手順です。
どこまでをAIに任せ、どこから一次データで確かめるかは、判断を誤ったときの事業への影響度に応じて切り分けます。
市場規模の推計、競合の比較軸への顧客評価の重ね合わせ、レビュー分類を活かした調査票の設計など、AIリサーチとアンケート調査は役割を分担させることで互いの強みが活きてきます。
効率はAIで確保し、意思決定の根拠はターゲット顧客から集めた一次データで固める体制づくりに、セルフ型アンケートツール QiQUMOとAIによる設問生成機能 QiQUMO Aiをお役立てください。